
BlogKünstliche Intelligenz
Welche KI-Modelle laufen lokal? Speicher, Kosten und Einsatz für KMU
Von Dominik Pototschnig15 Min.

In diesem Beitrag
Ein Modell kann auf dem Datenblatt klein wirken und trotzdem nicht in Ihr System passen: Aktive Parameter sind kein Speicherwert, Kontext und Runtime kommen dazu. Entscheiden Sie deshalb erst nach einem gemessenen Abnahmetest.
Kurzantwort: Lokal betreibbare KI reicht 2026 von Gemma 4 E2B/E4B und Qwen3.5-4B bis zu gpt-oss-120b und Mistral Small 4, deren genannte Herstelleranker in der Serverklasse liegen. Sinnvolle Pilotaufgaben sind unter anderem Extraktion, Klassifikation, Zusammenfassung, Coding, RAG sowie Bild-, Dokument- und Sprachverarbeitung. Zwei österreichische Komplettsysteme mit 16 beziehungsweise 32 GB VRAM kosteten am Stichtag 3.415,85 Euro beziehungsweise 7.082,50 Euro netto; das sind volatile Retail-Momentaufnahmen, keine Marktbandbreite und keine Kompatibilitätszusage. Entscheidend sind die Gesamtkosten (TCO) je fachlich akzeptiertem Ergebnis. Für ein KMU ist daher der kleinste Kandidat richtig, der die eigene Aufgabe mit akzeptabler Qualität, Latenz und Nacharbeit erfüllt. Dimensionieren Sie Hardware erst mit dem exakten Modellartefakt, der Quantisierung, der Runtime, der gewünschten Kontextlänge und Parallelität.
Vier Testkorridore strukturieren die Vorauswahl: Gemma 4 E2B/E4B oder Qwen3.5-4B, die 7–14B-Klasse, Modelle um 20–32B und große Modelle ab 70B Gesamtparametern. Sie sind weder Rangliste noch Kaufempfehlung; testen Sie alle Kandidaten mit denselben fachlichen Beispielen.
Dieser Beitrag behandelt lokale Inferenz: Ein fertiges Modell erzeugt Antworten auf eigener oder selbst kontrollierter Hardware, nicht das Training großer Basismodelle. „Lokal“ macht die Anwendung nicht automatisch offline – externe Werkzeuge, Updates oder Datenquellen bleiben separat zu betrachten.
Stand der Modell-, Lizenz-, Produkt- und Preisquellen: 15. September 2026. Anbieterangaben dienen der Vorauswahl und ersetzen keinen Test auf Ihrer Hardware. Modelle, Dokumentation, Preise und Bedingungen können sich ändern.
Warum die Modellwahl eine wirtschaftliche Entscheidung ist
Der Kaufpreis einer Workstation beantwortet nicht, ob lokale KI wirtschaftlich ist. Entscheidend sind die Gesamtkosten über einen festgelegten Zeitraum – die Total Cost of Ownership (TCO) – und die Zahl der Ergebnisse, die Ihre Fachabteilung tatsächlich akzeptiert.
Ein kleines Modell kann günstig zu laden sein und dennoch teuer werden, wenn Mitarbeitende jede Ausgabe korrigieren müssen. Ein größeres Modell kann fachlich besser passen, aber durch Hardware, Strom, Betrieb und Ausfallvorsorge unwirtschaftlich sein. Umgekehrt kann ein vorhandenes Gerät für ein Pilotprojekt genügen, ohne dass daraus automatisch ein kostenloser Dauerbetrieb folgt.
Die belastbare Zielgröße lautet deshalb nicht „Preis pro GPU“, sondern:
Kosten je fachlich akzeptiertem Ergebnis = TCO im Zeitraum / Zahl der fachlich akzeptierten Ergebnisse.
Die konkrete Zähleinheit legen Sie vor dem Test je Prozess fest: bei der Extraktion etwa ein fachlich freigegebenes Dokument, beim Coding ein nach Tests und Review übernommener Patch, bei Zusammenfassungen eine ohne materielle Auslassung freigegebene Zusammenfassung. Demo-Aufrufe ohne fachliche Abnahme gehören nicht in den Nenner.
Parameter, Quantisierung und RAM/VRAM: die Zahlen richtig lesen
Fünf Begriffe verhindern die häufigsten Fehlentscheidungen:
- Gesamtparameter sind alle Gewichte, die ein Modell enthält und grundsätzlich laden muss.
- Aktive Parameter bezeichnen bei einer Mixture-of-Experts-Architektur, kurz MoE, nur den Teil, der pro Token berechnet wird. Sie sind keine Speichergröße.
- Effektive Parameter sind eine herstellerspezifische Bezeichnung, etwa bei Gemma E2B/E4B. Lesen Sie sie immer gemeinsam mit der Zahl der Gesamtparameter.
- Quantisierung speichert Gewichte mit geringerer Bitbreite und kann damit den Speicherbedarf reduzieren. llama.cpp unterstützt laut Projektdokumentation Quantisierungen von 1,5 bis 8 Bit sowie CPU-/GPU-Hybrid-Offload; daraus folgt weder eine Qualitäts- noch eine Tempozusage für Ihr Gerät.
- Kontext und KV-Cache benötigen zusätzlichen Laufzeitspeicher für Eingabe und erzeugte Tokens. Runtime, Puffer, multimodale Encoder und parallele Sitzungen kommen ebenfalls hinzu.
Für dichte Gewichte liefert diese Rechnung nur eine Untergrenze:
Gewichtsspeicher ≈ Parameter × Bitbreite / 8Zwölf Milliarden Parameter bei exakt 4 Bit ergeben rechnerisch 6 GB. Das sind weder der gesamte RAM- noch der gesamte VRAM-Bedarf. Format- und Runtime-Overhead, Kontext und Parallelität fehlen. Auf effektive oder aktive MoE-Parameter darf die Rechnung nicht angewendet werden.
Ein konkretes Beispiel zeigt die Falle: Bei Gemma 4 26B A4B werden laut Google-Dokumentation pro Token rund 4B Parameter aktiviert, für schnelle Inferenz aber alle 26B Gewichte geladen. Googles Ladeschätzungen enthalten zwar 20 Prozent Lade-Overhead, ausdrücklich aber weder unterstützende Software noch den Kontext-KV-Cache. Die Werte dürfen daher nicht auf andere Modellfamilien übertragen werden.
RAM, dedizierter VRAM und Unified Memory sind unterschiedliche Speicherarchitekturen und keine austauschbaren Prospektzahlen. CPU-Offload kann ein Modell mit ausreichend RAM startbar machen; Mistral beschreibt ihn in seiner Offline-Dokumentation jedoch als deutlich langsamer. Ob das für Ihren Prozess genügt, entscheidet eine Latenzmessung.
Für die Messung kann Ollama beim konkret geladenen Artefakt unter anderem Parametergröße, Quantisierungsstufe, Kontextmetadaten, geladene Größe und size_vram ausgeben. Diese Telemetrie beschreibt den gemessenen Lauf – nicht alle Varianten eines Modells.
Welche KI-Modelle kann man lokal betreiben? Vier Testkorridore
Die folgende Matrix ist eine kuratierte Startauswahl, keine vollständige Modellliste. Speicherwerte sind offizielle Anbieteranker mit engem Geltungsbereich; fehlende Werte bleiben bewusst offen.
| Klasse und Kandidaten | Parameter und Modalität | Offizieller Speicher- oder Hardwareanker | Sinnvoller eigener Test | Harte Grenze und Lizenzhinweis |
|---|---|---|---|---|
| Klein: Gemma 4 E2B/E4B, Qwen3.5-4B | Gemma E2B/E4B: Text, Bild und Audio hinein, Text heraus; Qwen: 4B, Bild und Text hinein, Text heraus | Google nennt für Gemma Q4_0 ca. 2,9/4,5 GB inklusive 20 % Lade-Overhead, aber ohne Software und KV-Cache. Für Qwen wird hier keine Speicherzusage übernommen. | Extraktion, Klassifikation, kurze Entwürfe sowie Bild- und Dokumenttests | Dokumenttyp, Sprache und Genauigkeit selbst prüfen. Beide Modellkarten nennen Apache 2.0; exaktes Artefakt und Bedingungen erneut prüfen. |
| 7–14B: Gemma 4 12B | Text, Bild und Audio hinein, Text heraus | Google nennt für Q4_0 ca. 6,7 GB inklusive 20 % Lade-Overhead, ohne Software und KV-Cache. | Anspruchsvollere strukturierte Text- und multimodale Aufgaben | „6,7 GB laden“ heißt nicht „passt sicher in 8 GB“. Kontext und Runtime kommen hinzu. Modellkarte: Apache 2.0; konkretes Artefakt prüfen. |
| 20–32B: Gemma 4 26B A4B/31B, gpt-oss-20b, Devstral Small 2 | gpt-oss: 21B gesamt/3,6B aktiv, nur Text, Function Calling und strukturierte Ausgaben; Devstral: dichtes 24B-Codingmodell | Gemma Q4_0: ca. 14,4/17,5 GB, inklusive 20 % Lade-Overhead, aber ohne Software und KV-Cache; nur für die genannten Gemma-4-Q4_0-Artefakte. Mistral ordnet Devstral bei 4 Bit und 32K Kontext einer 24-GB-VRAM-Klasse zu. Für gpt-oss wird keine Speicherzahl ergänzt. | gpt-oss: strukturierte Ausgaben und Werkzeugaufrufe unter kontrollierten Berechtigungen; Devstral: Test am eigenen Code | Aktive Parameter sind kein Gewichtsspeicher. Devstral-Anker gilt nur für 4 Bit/32K. gpt-oss nennt Apache 2.0; Lizenzen und Artefakte einzeln prüfen. |
| 70B und größer: gpt-oss-120b, Mistral Small 4 | gpt-oss: 117B gesamt/5,1B aktiv und nur Text; Small 4: 119B gesamt/6B aktiv je Token sowie Text und Bild | OpenAI beschreibt gpt-oss-120b für eine einzelne NVIDIA H100. Mistrals Offline-Doku nennt für Small 4 bei FP8 mindestens eine H100 mit 80 GB und mehr Speicher für lange Kontexte. | gpt-oss: Textaufgaben mit eigenen Qualitäts- und Latenzkriterien; Small 4 zusätzlich für Bild-Text-Aufgaben | Die genannten Herstelleranker liegen in der Serverklasse; abweichende Quantisierungs-, Offload- oder Unified-Memory-Konfigurationen separat messen. Beide Quellen nennen Apache 2.0; Artefakt prüfen. |
Beginnen Sie nicht automatisch in der obersten Zeile. Nutzen Sie für alle Kandidaten denselben Datensatz, dieselben Abnahmekriterien und dasselbe Latenzziel. Erst dann wird aus einer Modellkarte eine Investitionsgrundlage.
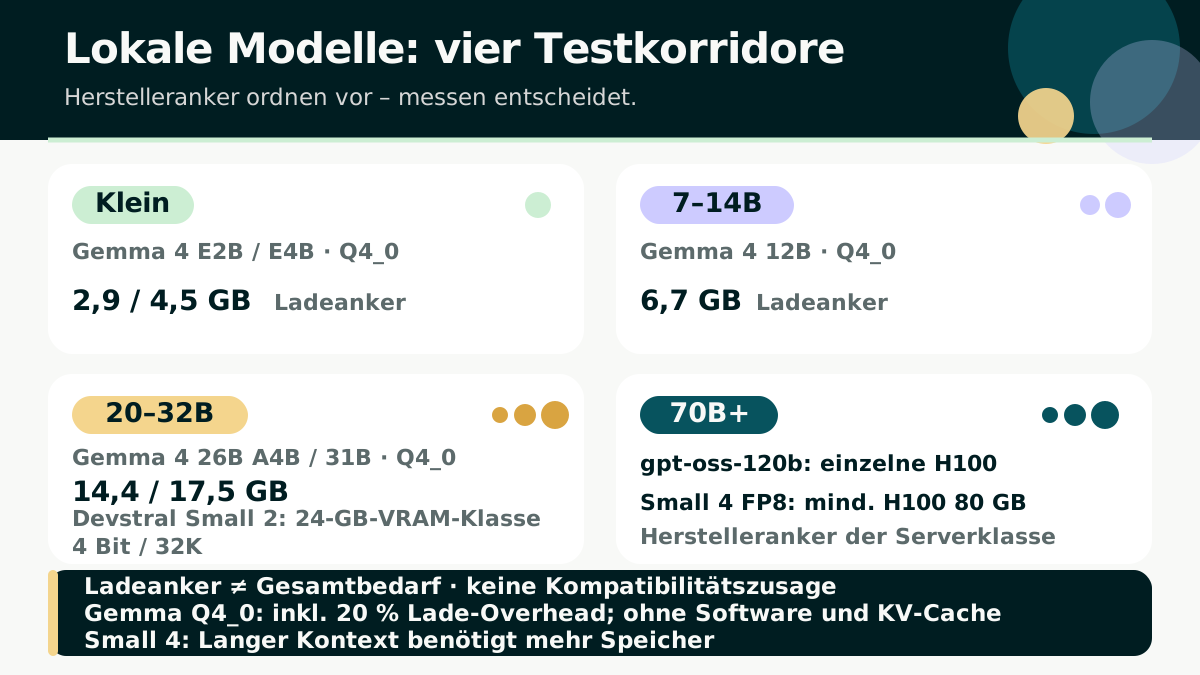
Kuratierte Testkorridore auf Basis der verlinkten Herstellerquellen, Stand 15. September 2026. Ein Lade- oder Hardwareanker ist weder der gesamte Systembedarf noch eine Kompatibilitätszusage.
Welche Aufgaben sind lokal sinnvoll? Messen statt Fähigkeitsbezeichnung übernehmen
Ein Hinweis wie „Vision“, „Coding“ oder „Function Calling“ belegt eine technische Fähigkeit, nicht die Eignung für Ihren Prozess. Die Abnahme sollte je Aufgabe anders aussehen:
| Aufgabe | Messen Sie im Pilotprojekt | Leiten Sie nicht aus der Modellkarte ab |
|---|---|---|
| Extraktion und Klassifikation | Feldgenauigkeit, ungültige Strukturquote und Nacharbeitszeit je Dokumenttyp | autonome Freigabe oder universelle OCR-Qualität |
| Entwurf und Zusammenfassung | Faktenfehler, Auslassungen und Zeit bis zur menschlichen Freigabe | aktuelle oder fehlerfreie Fakten |
| Coding | Projekttests, Patch-Akzeptanz und Reviewzeit im eigenen Repository | ein allgemeiner Coding-Benchmark sei Ihr Projektnutzen |
| RAG und Firmensuche | Quellenabdeckung und Retrieval getrennt von Zitattreue, Verweigerung und Berechtigungen | ein Embeddingmodell sei ein fertiges RAG-System |
| Vision und OCR | Feld- und Seitengenauigkeit je Scan-, Layout- und Dokumentklasse | Bildfähigkeit sei belastbare Dokumentautomatisierung |
| Sprache | Fehlerrate und Korrekturzeit je Sprache, Dialekt, Akustik und Fachvokabular | ein VRAM-Wert bedeute gleiche Sprachqualität |
| Agentischer Ablauf | Erfolgsquote je Werkzeugschritt, Berechtigungen, Abbruch, Wiederanlauf und menschliche Eskalation | Function Calling mache einen Prozess autonom sicher |
RAG braucht mehr als ein Chatmodell
Bei Retrieval-Augmented Generation, kurz RAG, werden interne Inhalte zunächst gesucht und bewertet, bevor ein generatives Modell antwortet. Qwen bietet Qwen3 Embedding und Reranker laut eigener Dokumentation in 0,6B-, 4B- und 8B-Varianten mit 32K Sequenzlänge unter Apache 2.0 an. Embeddings erzeugen semantische Vektoren, ein Reranker bewertet Anfrage-Dokument-Paare. Beides ersetzt weder das Antwortmodell noch Berechtigungen, Datenrechte und eine getrennte Prüfung von Retrieval und Antwort.
Für Sprache kann ein Spezialmodell sinnvoller sein
Whisper unterstützt laut Upstream-Dokumentation mehrsprachige Spracherkennung, Sprachidentifikation und Übersetzung. Die offiziellen Varianten nennen ungefähr 1 bis 10 GB erforderlichen VRAM; Leistung bleibt stark von Sprache, Akustik und Hardware abhängig. turbo ist laut Upstream nicht für Übersetzung trainiert. Code und Gewichte stehen dort unter MIT – auch hier ist das konkret eingesetzte Paket zu prüfen.
Hardwarekorridore mit zwei österreichischen Preisankern
Ein seriöser Anschaffungspreis ist nur mit Land, Währung, Steuerbasis, vollständiger CPU-/GPU-/Speicherkonfiguration, Bestellstatus und Stichtag vergleichbar. Die folgenden zwei Preise sind deshalb belegte Momentaufnahmen aus Österreich – keine allgemeine Preisspanne.
| Korridor | Dokumentierte Konfiguration und Quelle | Anschaffung in Österreich am 15.09.2026 | Harte Einordnung |
|---|---|---|---|
| Vorhandenes Gerät / kleines Modell | Reales Gerät mit dokumentiertem freien Speicher, Runtime, Quantisierung und Dauerlast; Kandidaten etwa Gemma 4 E2B/E4B oder Qwen3.5-4B mit reduziertem Kontext | 0 € Zusatzkauf nur, wenn das Gerät tatsächlich frei verfügbar ist | Opportunitätskosten, Einrichtung, Strom, Administration und Nacharbeit bleiben bestehen. |
| 16 GB dedizierter VRAM | Dell Österreich: Alienware Aurora ACT1250, act1250_cto7: Core Ultra 7 265KF, RTX 5070 Ti 16 GB GDDR7, 32 GB DDR5, 1-TB-NVMe-SSD, Windows 11 Home; als bestellbar angezeigt |
3.415,85 € netto / 4.099,02 € brutto | Volatile Retail- und Gaming-Konfiguration, keine Business-Ausstattung, Kaufempfehlung, Performance- oder Modell-/Quantisierungs-/Kontext-Kompatibilitätszusage. |
| 32 GB dedizierter VRAM | Dell Österreich: Alienware Area-51 AAT2250, aat2250_cto5: Core Ultra 9 285K, RTX 5090 32 GB GDDR7, 64 GB DDR5, 2-TB-NVMe-SSD, Windows 11 Home; als bestellbar angezeigt |
7.082,50 € netto / 8.499,00 € brutto | Volatile Retail- und Gaming-Konfiguration, keine Business-Ausstattung, Kaufempfehlung, Performance- oder Modell-/Quantisierungs-/Kontext-Kompatibilitätszusage. |
| H100- oder Mehrbeschleunigerklasse | gpt-oss-120b mit OpenAIs H100-Anker; Small 4 mit Mistrals FP8-/H100-80-GB-Anker | Individuelles vollständiges Serverangebot erforderlich | GPU-Typ und -Anzahl, VRAM, CPU, RAM, SSD, OS, Support, Redundanz, Kühlung, Stromkreis/Standort, Ersatzstrategie, Land, Währung, Steuerbasis, Lieferstatus und Datum vollständig anfordern. |
Die beiden Preise sind nur Budgetreferenzen und keine Zusage, dass ein Modell mit Ihrer Runtime, Kontextlänge, Quantisierung und Parallelität passt. Für die Kaufentscheidung benötigen Sie mindestens zwei aktuelle, vergleichbare Business-Angebote mit derselben Prüfliste.
Was lokale KI wirklich kostet: TCO statt Grafikkartenpreis
Lokale KI kostet nicht nur den Preis einer Grafikkarte. Sie kostet Anschaffung, Evaluation, Strom, Betrieb, Ausfallreserve und menschliche Nacharbeit – abzüglich Restwert.
Stromkosten = gemessene mittlere Wandlast (kW)
              × Betriebsstunden
              × eigener All-in-Strompreis (€/kWh)

TCO im Zeitraum = Anschaffung
                  + Einrichtung und Evaluation
                  + Strom
                  + Kühlung und Standort
                  + Administration, Updates und Monitoring
                  + Support, Ersatzteile und Ausfallreserve
                  + menschliche Prüfung und Nacharbeit
                  - Restwert

Kosten je fachlich akzeptiertem Ergebnis
  = TCO / Zahl der fachlich akzeptierten Ergebnisse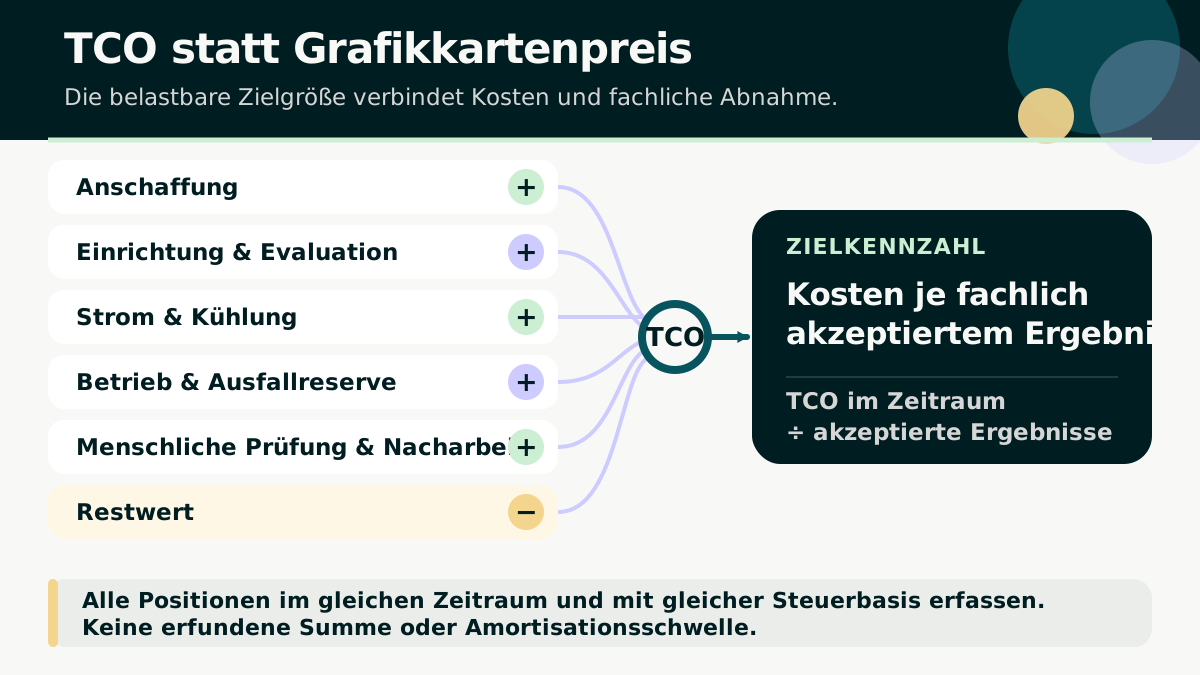
Wogenfels-Kostenmodell ohne erfundene Summe oder Amortisationsschwelle. Zeitraum, Steuerbasis und firmeneigene Werte müssen für alle Optionen identisch sein.
Vergleichen Sie Bestandsgerät, Hardwarekauf und Cloud-Pilot über denselben Zeitraum und dieselbe Steuerbasis. Jede Spalte braucht dieselben Kostenkategorien; null ist nur zulässig, wenn eine Position nachweislich nicht anfällt.
| TCO-Kategorie | Bestandsgerät | Hardwarekauf | Cloud-Pilot |
|---|---|---|---|
| Anschaffung oder Nutzung | Anteilige Geräte- und Opportunitätskosten | Vollständiger Kaufpreis | Firmeneigener Cloud-Nutzungswert in Euro für denselben Zeitraum, aus Pilotverbrauch und Rechnung |
| Einrichtung und Evaluation | Interne und externe Arbeitszeit | Interne und externe Arbeitszeit | Interne und externe Arbeitszeit |
| Strom | Gemessene Wandlast | Gemessene Wandlast | Lokale Last und gesondert verrechnete Infrastruktur |
| Kühlung und Standort | Tatsächlicher Anteil | Tatsächlicher Anteil | Tatsächlich zusätzlich anfallende Positionen |
| Administration, Updates und Monitoring | Tatsächlicher Aufwand | Tatsächlicher Aufwand | Tatsächlicher Aufwand |
| Support, Ersatzteile und Ausfallreserve | Gerätespezifischer Anteil | Angebot und interne Reserve | Vertrag, interne Reserve und Ausfallfolgen |
| Menschliche Prüfung und Nacharbeit | Gemessene Fachzeit | Gemessene Fachzeit | Gemessene Fachzeit |
| Restwert | Anteiligen Restwert abziehen | Erwarteten Restwert abziehen | Nur einen tatsächlich vorhandenen Restwert abziehen |
Halten Sie Zeitraum und Steuerbasis in allen Angeboten und Kostenpositionen konsistent. Setzen Sie für Strom die gemessene Wandlast und Ihren tatsächlichen All-in-Unternehmenspreis ein.
Nur um die Rechnung greifbar zu machen: Statistik Austria weist für privaten Einsatz im vorläufigen Jahr 2025 durchschnittlich 0,293 Euro brutto je kWh aus. Das ist kein KMU-Tarif und keine Prognose.
0,25 kW × 2.000 h × 0,293 €/kWh = 146,50 € pro Jahr0,60 kW × 8.760 h × 0,293 €/kWh = 1.540,01 € pro Jahr
Das zweite Beispiel unterstellt 24/7-Betrieb. Beide Rechnungen lassen Kühlung, Lastspitzen, Leerlauf, USV und Ausfälle unberücksichtigt. Für Ihre Entscheidung ersetzen Sie deshalb sowohl die Wandlast als auch den Strompreis durch Mess- und Rechnungswerte des Unternehmens.
Der Fünfschritt-Pilot vor dem Hardwarekauf
- Aufgabe und Abnahme definieren. Wählen Sie einen konkreten Prozess, repräsentative Beispiele, eine eindeutige Zähleinheit und ein fachliches Akzeptanzkriterium. Erfassen Sie auch Nacharbeitszeit und Fehler, die eine menschliche Eskalation erfordern.
- Den kleinsten plausiblen Kandidaten wählen. Starten Sie mit der niedrigsten Modellklasse, deren dokumentierte Modalität zur Aufgabe passt. Ein Cloud-Pilot kann eine Alternative bleiben, wenn passende lokale Hardware noch nicht vorhanden ist.
- Die dokumentierte Testkonfiguration festhalten. Dokumentieren Sie exaktes Modellartefakt und Version oder Hash, Quantisierung, Runtime-Version, Hardware, Kontextlänge und Zahl paralleler Sitzungen. Nur so bleibt der Test wiederholbar.
- Qualität, Latenz und Last gemeinsam messen. Protokollieren Sie die aufgabenspezifischen Qualitätswerte, Laufzeit, geladene Größe, die in VRAM geladene Größe (
size_vram), Wandlast und menschliche Nacharbeit. Ändern Sie jeweils nur einen Faktor dieser Konfiguration. - TCO rechnen und erst dann entscheiden. Vergleichen Sie zwei vollständige Business-Angebote sowie Bestandsgerät und Cloud-Pilot mit denselben TCO-Kategorien. Berechnen Sie die Kosten je fachlich akzeptiertem Ergebnis. Das Ergebnis kann eigener Hardwarekauf, Nutzung eines Bestandsgeräts oder bewusst Cloud/Hybrid sein.
Ein brauchbares Messprotokoll enthält damit mindestens: Modellversion oder Hash, Quantisierung, Runtime-Version, Hardware und Speicherarchitektur, Kontext, Parallelität, Qualitätskriterien, Latenz, Wandlast sowie menschliche Prüf- und Nacharbeitszeit. Erst dieser Datensatz macht Varianten vergleichbar.
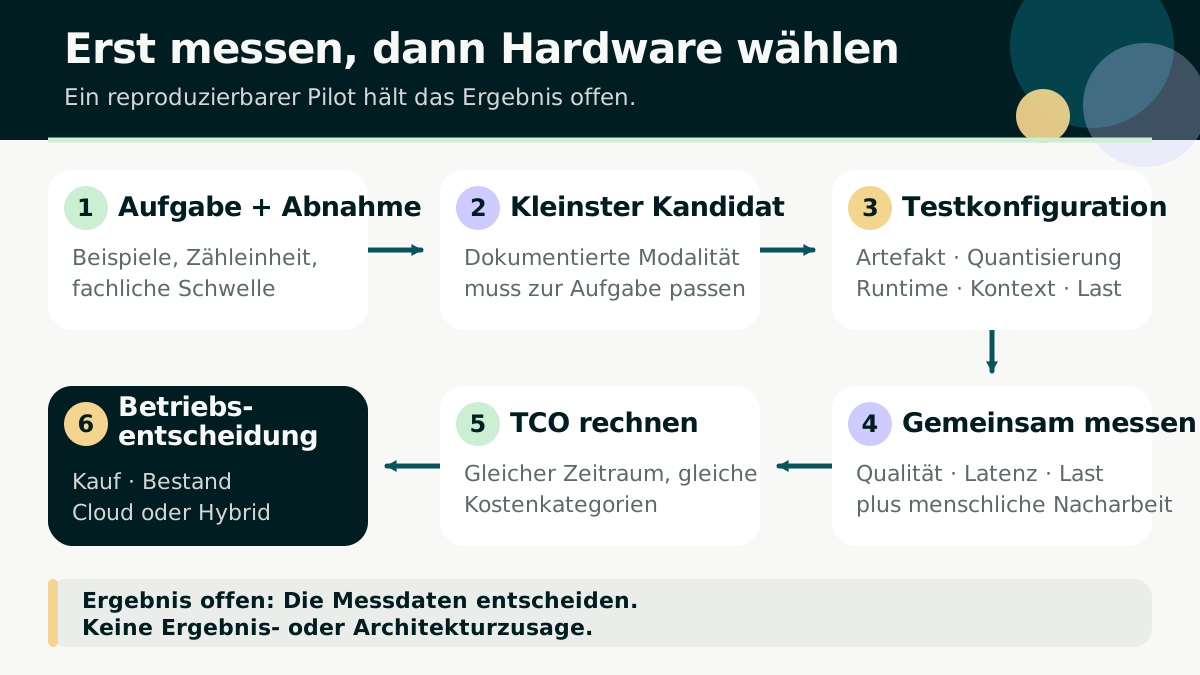
Reproduzierbarer Pilotablauf von Wogenfels. Die Messdaten entscheiden; die Grafik gibt weder ein Ergebnis noch eine Zielarchitektur vor.
Lizenz, Datenschutz und die Grenze zum Training
Offene Gewichte sind nicht automatisch Open Source. Die Open Source AI Definition 1.0 der OSI verlangt Freiheiten zum Nutzen, Untersuchen, Verändern und Teilen sowie Zugang zur bevorzugten Änderungsform mit ausreichender Dateninformation, Code und Parametern. Daraus folgt keine automatische Einordnung der hier genannten Modelle. Prüfen Sie vor dem produktiven Einsatz Lizenz, Modellkarte und Bedingungen des exakten Artefakts erneut. Apache 2.0 oder MIT wird in diesem Beitrag nur dort genannt, wo die jeweilige Primärquelle es für das konkrete Modell beziehungsweise Upstream-Projekt ausweist; eine pauschale kommerzielle Freigabe ist das nicht.
Lokal ist nicht automatisch DSGVO-konform. Wenn eine KI personenbezogene Daten verarbeitet, bleibt die DSGVO laut österreichischer Datenschutzbehörde anwendbar; sie nennt insbesondere Datenschutzgrundsätze und einen passenden Rechtfertigungstatbestand als Prüfpunkte. Lokale Ausführung kann externe Datenwege reduzieren, ersetzt aber keine Prüfung der konkreten Verarbeitung. Die Architekturentscheidung vertieft der Beitrag „Nur lokale KI ist DSGVO-konform? Der Faktencheck für KMU“.
Der hier beschriebene Hardwarebedarf betrifft Inferenz. Fine-Tuning benötigt eine eigene Kalkulation für Speicher, Datenpipeline und Betrieb. Das Training großer Basismodelle liegt außerhalb dieses Vergleichs.
Fazit: Kaufen Sie den Nachweis, nicht die größte Parameterzahl
Die passende lokale KI ist der kleinste Kandidat, der Ihre fachliche Abnahme erfüllt – nicht grundsätzlich das kleinste und nicht automatisch das größte Modell. Parameterklassen und Herstellerangaben grenzen Tests ein. Die Investitionsentscheidung entsteht erst aus der gemessenen, dokumentierten Testkonfiguration, der menschlichen Nacharbeit und den Kosten je fachlich akzeptiertem Ergebnis.
Wenn Sie diese Entscheidung strukturiert vorbereiten möchten, finden Sie auf der Seite KI-Lösungen für Unternehmen den Umsetzungskontext. Für ein konkretes Pilotgespräch können Sie einen Termin vereinbaren. Bringen Sie dafür die Aufgabe, rechtmäßig nutzbare Beispieldaten, vorhandene Hardware- oder Angebotsdaten und Ihre Abnahmekriterien mit. Daraus lässt sich ein messbares Pilotprojekt ableiten, ohne vorab eine bestimmte Modell- oder Hardwareklasse zu versprechen.
Quellenstand und Einordnung
Das Quellenverzeichnis umfasst 17 Direktquellen mit Abrufstand 15. September 2026. 16 davon waren inhaltlich direkt prüfbar. EUR-Lex lieferte bei der Prüfung nur eine JavaScript-/Bot-Sperrseite und wird deshalb ausschließlich als autoritativer Link zum DSGVO-Text verwendet; daraus leitet dieser Beitrag keine neue granulare Normauslegung ab. Anbieterquellen sind keine unabhängigen Leistungs- oder Preisvergleiche. Prüfen Sie volatile Modell-, Lizenz-, Hardware- und Preisangaben vor Veröffentlichung oder Kauf erneut.
- Runtimes: llama.cpp, Ollama API
- Gemma 4: Modellübersicht, Modellkarte
- OpenAI-Modelle: gpt-oss-20b, gpt-oss-120b
- Mistral: Mistral Small 4, Offline-Modelle und Hardwareanker
- Qwen: Qwen3.5-4B, Qwen3 Embedding und Reranker
- Sprache: Whisper Upstream
- Lizenzdefinition: Open Source AI Definition 1.0
- Kostenreferenz: Statistik Austria – Energiepreise und -steuern
- Datenschutzrahmen: DSGVO auf EUR-Lex, österreichische Datenschutzbehörde zu DSGVO und KI-VO
- Österreichische Preisanker: Dell Alienware Aurora ACT1250, Dell Alienware Area-51 AAT2250
- Lokale KI
- KI-Modelle
- VRAM
- Hardware
- TCO
Weitere Beiträge
Bestellmails mit KI verarbeiten: Architektur-Fallstudie
Ein geprüfter Entwicklungsstand zeigt, wie Bestellmails und PDFs zu kontrollierten ERP-Vorschlägen werden, mit Menschenprüfung und Xentral-Anbindung.
Mein Web-Stack für KMU: statisch starten, dynamisch ergänzen
Warum Wogenfels KMU-Websites mit Astro statisch beginnt, Dynamik per Hono abgrenzt, Persistenz nur vorbereitet und Qualität automatisiert prüft.
Hermes Agent oder n8n? So bauen KMU einen kontrollierten KI-Mitarbeiter
Hermes Agent oder n8n? Der Vergleich zeigt KMU, wann ein Agent, ein fester Workflow oder eine kontrollierte Kombination sinnvoll ist.