
BlogKünstliche Intelligenz
Bestellmails mit KI verarbeiten: Architektur-Fallstudie
Von Dominik Pototschnig21 Min.

In diesem Beitrag
Eine falsche Antwort im Chat ist ärgerlich. Ein erfundener Artikel in einem freigegebenen ERP-Auftrag kann eine reale Fehllieferung auslösen.
Genau deshalb beginnt belastbare KI-Auftragserfassung nicht mit einem spektakulären Prompt. Sie beginnt mit Grenzen: Welche E-Mail ist tatsächlich eine Bestellung? Welche Kunden und Artikel darf das Modell überhaupt auswählen? Was muss ein Mensch prüfen? Unter welchen Bedingungen darf etwas ins ERP geschrieben werden? Und welche personenbezogenen Daten verlassen dabei welches System?
Ein Projekt für WG Salesmanagement zeigt, wie aus Bestellmails und PDF-Anhängen ein strukturierter, prüfbarer Auftragsvorschlag entstehen kann. Der interessante Teil ist nicht der einzelne Modellaufruf. Entscheidend ist die Kette rundherum: Microsoft-365-Postfach, Stammdatenabgleich, retrieval-gestützte Kandidatensuche, strukturierte Ausgabe, Nachvalidierung, menschliche Freigabe, Dublettenschutz und Xentral-Anbindung.
Transparenz vorweg: Der geprüfte Entwicklungsstand nutzt die Gemini Developer API. Vertex AI ist in diesem Snapshot noch nicht implementiert, sondern als späterer Wechselpfad vorbereitet. Den vollständigen Prüfstand und seine Grenzen finden Sie am Ende des Beitrags.
Die Kurzfassung für Entscheider
Eine belastbare KI-Auftragserfassung unterscheidet sich von einer Demo durch eine kontrollierte Datenbasis, validierte Ausgaben, eine begrenzte geschäftliche Wirkung und einen messbaren Betrieb.
- Eine Bestellmail ist unstrukturiert, ein ERP-Auftrag nicht. Dazwischen braucht es mehr als Texterkennung.
- Das Modell sollte keine Kunden- oder Artikelnummern frei erzeugen. Es wählt aus einer kontrollierten Kandidatenmenge; unbekannte IDs werden anschließend entfernt.
- RAG bedeutet hier kein Chatten mit Dokumenten. Relevante Kunden und Produkte werden vor dem Modellaufruf aus echten Stammdaten zurückgeholt; Google beschreibt dieses Grundmuster als Retrieval-Augmented Generation.
- Ein Schema prüft die Form, nicht automatisch die Wahrheit. Mengen, Einheiten, Zuordnungen und Geschäftsregeln brauchen weitere Kontrollen.
- Human-in-the-loop ist ein Betriebsmodell, kein Button. Offene Fälle, Korrekturen, Verantwortliche und Eskalationen müssen im Alltag funktionieren.
- Vertex AI kann eine datenschutzkonforme Verarbeitung unterstützen, macht sie aber nicht automatisch DSGVO-konform. Vertrag, Rechtsgrundlage, Datenminimierung, Region, Löschung und Zugriffe bleiben nach der DSGVO konkrete Betreiberaufgaben; Google dokumentiert zusätzlich eigene Aufbewahrungs- und Konfigurationsfälle.
Projektbeleg für die projektspezifischen Aussagen: privater Repository-Snapshot, Commit 3655d58, geprüft am 15. September 2026. Der Hinweis belegt den untersuchten Codepfad, nicht einen produktiven Betrieb.
Für ein KMU lautet die erste Investitionsfrage deshalb nicht „Welches Modell nehmen wir?“, sondern: An welchem eng abgegrenzten Prozess können wir Nutzen und Risiko mit echten Belegen messen?
Das Prozessproblem bei WG Salesmanagement
WG Salesmanagement beschreibt sich als Vertriebs- und Consulting-Partner. Im untersuchten Projekt bildet eine Anwendung zwei getrennte Firmenkontexte mit jeweils zugeordnetem Postfach und Xentral-Zugang ab. Der zweite Firmenname ist für die Architekturentscheidung nicht erforderlich und wird hier bewusst nicht veröffentlicht.
Bestellungen kommen nicht als saubere API-Nachricht. Sie kommen als E-Mail-Text, HTML-Nachricht oder PDF, oft mit Tabellen, kundeneigenen Artikelbezeichnungen, Bestellnummern, abweichenden Lieferadressen und unterschiedlich geschriebenen Einheiten. Das Zielsystem benötigt dagegen eindeutige Felder: Kunde, Artikel, Menge, Einheit, Bestellnummer und gegebenenfalls Lieferinformationen.
Damit treffen zwei Welten aufeinander:
- Eingang: sprachlich, layoutabhängig, manchmal unvollständig und von Dritten geschrieben.
- ERP: strukturiert, referenziell und geschäftswirksam.
Ein Modell kann diese Lücke gut interpretieren. Es sollte sie aber nicht allein verantworten. Der Projektansatz teilt die Aufgabe deshalb in deterministische und probabilistische Schritte. Was sich zuverlässig über Absender, Nummern, Regeln oder Datenbankabfragen bestimmen lässt, wird vor dem Modell geklärt. Das Modell bearbeitet die verbleibende Mehrdeutigkeit. Danach prüft die Anwendung seine Ausgabe erneut.
Das ist ein wichtiger Architekturgrundsatz: KI dort einsetzen, wo Interpretation nötig ist; klassische Software dort, wo eine Regel sicher geprüft werden kann.
So lassen sich Bestellmails mit KI verarbeiten: vom Postfach zum ERP-Vorschlag
Der geprüfte Entwicklungsstand bildet folgenden Ablauf ab:
- E-Mail-Eingang: Die Anwendung ruft Nachrichten über Microsoft Graph aus dem jeweils zugeordneten Postfach ab. Für einen robusten Betrieb lassen sich Webhooks und Delta-Abgleich kombinieren, damit ein verpasstes Ereignis nicht dauerhaft zum blinden Fleck wird. Microsoft dokumentiert sowohl Änderungsbenachrichtigungen als auch die Delta-Abfrage für Nachrichten. Der Snapshot belegt den Graph-Abruf, aber nicht, dass beide Sicherungswege produktiv gemeinsam betrieben werden.
- Ablage: E-Mail-Inhalt und zulässige PDF-Anhänge werden dem richtigen Firmenkontext zugeordnet und ohne Doppelablage gespeichert.
- Vorermittlung: Absender, bekannte Kontakte, Regeln und frühere Korrekturen liefern deterministische Hinweise.
- Kandidatensuche: Kunden und Artikel kommen aus dem Xentral-Spiegel. Je nach Bestandsgröße geht der gesamte relevante Stamm oder eine über exakte, fehlertolerante und semantische Suche eingegrenzte Menge weiter.
- Extraktion: Das Modell erhält E-Mail, PDF, Kontext und die geschlossene Kandidatenmenge. Es liefert ein strukturiertes Objekt statt freien Fließtext.
- Nachprüfung: Schema, erlaubte IDs und fachliche Mindestbedingungen werden außerhalb des Modells geprüft.
- Entscheidung: Ein Mensch kann Originalbeleg und Vorschlag vergleichen, korrigieren, ablehnen oder freigeben. Eine gesonderte Automatik ist möglich, im Datenmodell aber standardmäßig deaktiviert.
- ERP-Übergabe: Vor einem Schreibvorgang greifen Zustands-, Vollständigkeits- und Dublettenprüfungen. Erst danach kann ein Auftrag in Xentral entstehen.
Projektbeleg: privater Repository-Snapshot, Commit 3655d58, geprüft am 15. September 2026. „Implementiert“ bezeichnet den Codepfad, nicht dessen produktive Aktivierung oder Abnahme.
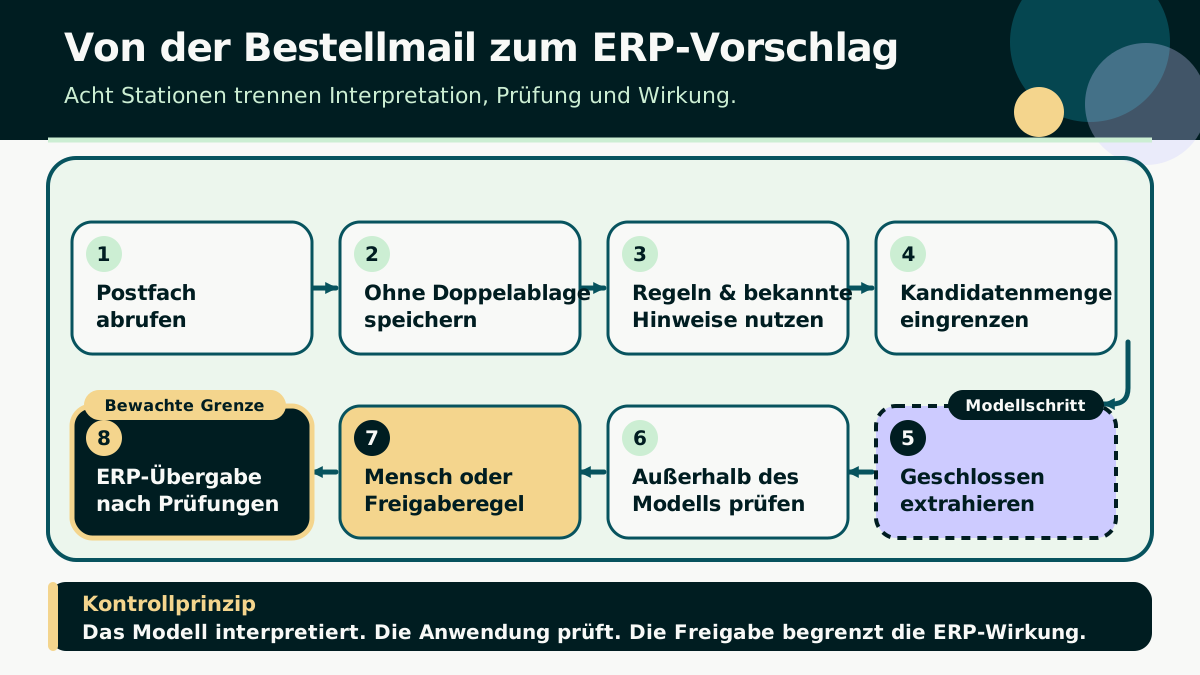
Diese Kette ist absichtlich länger als eine Demo mit „PDF hinein, JSON heraus“. Jeder zusätzliche Kontrollpunkt beantwortet eine andere Fehlerklasse.
OCR, Regeln oder Sprachmodell: Was löst welches Problem?
Nicht jede Bestellverarbeitung braucht ein Sprachmodell. Die richtige Lösung hängt von der Varianz der Eingänge und vom Schaden eines Fehlers ab.
Die folgende Tabelle ist eine qualitative redaktionelle Einordnung, keine allgemeingültige Rangliste.
| Ansatz | Gut geeignet, wenn | Typische Grenze | Aufwandstendenz |
|---|---|---|---|
| Vorlagen und feste Regeln | wenige, stabile Formate und eindeutige Felder vorliegen | Layout- und Sprachvarianten erzeugen viele Ausnahmen | niedrig bis mittel |
| OCR plus Mapping | gescannte Dokumente gelesen und bekannte Felder übertragen werden sollen | Texterkennung löst keine mehrdeutige Kunden- oder Artikelzuordnung | mittel |
| Allgemeiner LLM-Aufruf | ein schneller Machbarkeitstest für Interpretation nötig ist | freie Ausgabe, Halluzinationen und fehlende ERP-Grenzen | anfangs niedrig, im Betrieb riskant |
Die technische Auswahl ist noch keine Kaufentscheidung. Ob Standardsoftware oder eine individuelle Lösung wirtschaftlich sinnvoller ist, wird weiter unten mit denselben Muss-Kriterien und Gesamtkosten verglichen.
Die gefährlichste Variante ist häufig nicht „zu wenig KI“, sondern ein überzeugender Modell-Prototyp ohne kontrollierten Übergang in den Geschäftsprozess.
Was RAG in dieser Anwendung tatsächlich bedeutet
RAG steht für Retrieval-Augmented Generation: Vor dem Modellaufruf werden passende Informationen aus einer kontrollierten Quelle zurückgeholt und als Kontext bereitgestellt. In diesem Projekt ist „retrieval-gestützte, geschlossene Extraktion“ die präzisere Beschreibung.
Die Anwendung sucht Kandidaten auf bis zu drei Wegen:
- Exakt: Stimmen Kunden-, Artikel- oder andere eindeutige Nummern überein?
- Textnah: Findet eine fehlertolerante Suche ähnliche Namen und Schreibweisen?
- Semantisch: Liegt die Bedeutung nah beieinander, auch wenn andere Wörter verwendet werden?
Für den semantischen Weg entstehen Embeddings, also numerische Repräsentationen der Textbedeutung. pgvector ermöglicht deren Vergleich direkt in PostgreSQL; die Projektsuche kombiniert diesen Weg mit klassischen Treffern.
Bei kleineren Beständen verwendet der Snapshot jedoch den gesamten Kunden- oder Artikelstamm statt einer begrenzten Trefferliste. Das kann übersehene Treffer vermeiden, erhöht aber die übertragene Datenmenge. Gerade bei Kundenname und Anschrift ist das eine relevante Datenschutz- und Kostenfrage. RAG ist nicht automatisch Datenminimierung.
Projektbeleg: privater Repository-Snapshot, Commit 3655d58, geprüft am 15. September 2026. Die Suchschwellen sind im Code nicht als auf Produktionsdaten kalibriert ausgewiesen.
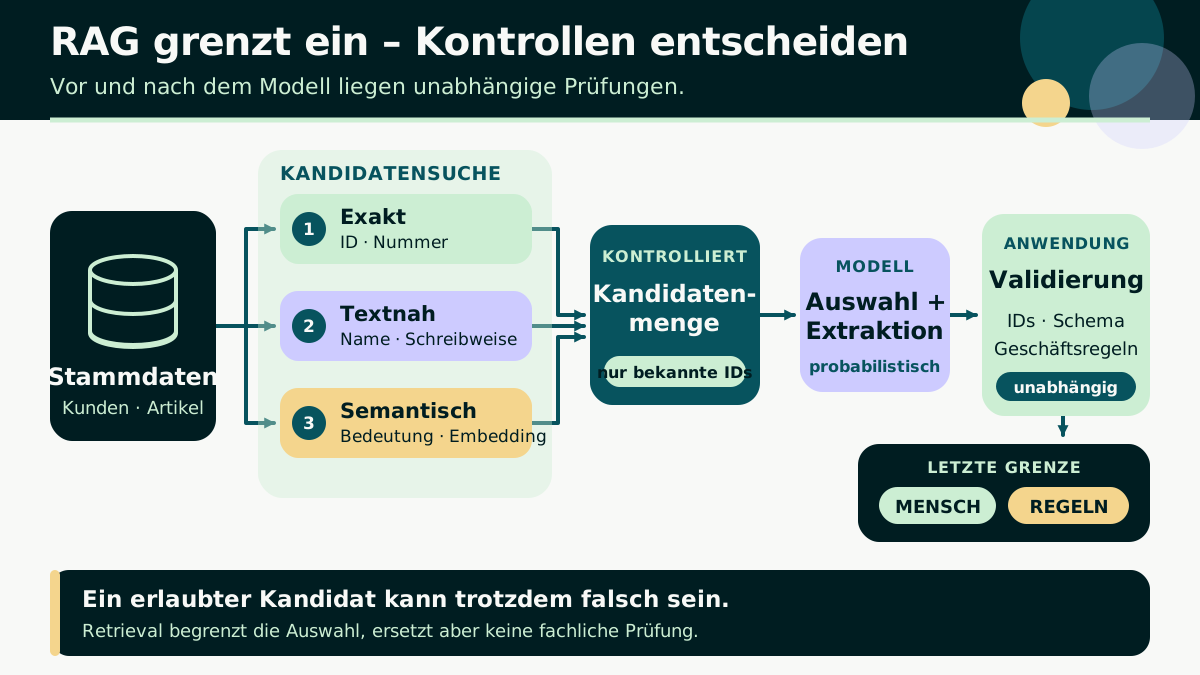
Der wichtigste Schutz liegt nach dem Retrieval: Das Modell darf nur IDs aus der vorgelegten Menge zurückgeben. Erfindet es eine andere Kennung, entfernt die Anwendung sie und setzt die Gesamtzuversicht herab. Das reduziert eine gefährliche Fehlerart deutlich. Es beweist aber nicht, dass ein erlaubter Kandidat auch der richtige ist.
RAG verhindert außerdem keine Prompt Injection. Eine E-Mail stammt von außen und kann Text enthalten, der wie eine Anweisung an das Modell klingt. Der Projektcode kapselt und begrenzt Fremdtext; die OWASP-Leitlinie zu Prompt Injection empfiehlt ebenfalls mehrschichtige Kontrollen. Die belastbare Grenze ist nicht „Das Modell wurde streng angewiesen“, sondern: Welche Wirkung kann seine Ausgabe nach unabhängigen Prüfungen noch entfalten?
Auch ein späterer Providerwechsel betrifft die Suche: Ändert sich das Embedding-Modell oder dessen Repräsentationsraum, müssen vorhandene Kunden-, Artikel- und Korrekturrepräsentationen neu erzeugt werden. Andernfalls würde die Suche nicht mehr Vergleichbares miteinander vergleichen.
PDF-Verständnis und strukturierte Ausgabe: zwei verschiedene Aufgaben
Viele Bestell-PDFs enthalten Tabellen. Eine reine Textextraktion kann zwar alle Wörter finden, aber die Beziehung zwischen Zeile, Menge und Einheit verlieren. Der geprüfte Code reicht PDFs deshalb mit @ai-sdk/google als Dateianteile an die Gemini Developer API weiter. Der offizielle Google-Provider des AI SDK dokumentiert diese Eingabeform. Googles Dokumentverständnis für Vertex AI zeigt die entsprechende Plattformfähigkeit, ist aber kein Beleg dafür, dass Vertex im aktuellen Projekt bereits verwendet wird.
Das Ergebnis wird anschließend gegen ein Zod-Schema geprüft. Der AI SDK unterstützt strukturierte Ausgaben über ein vorgegebenes Schema. Das sorgt dafür, dass Felder, Typen und Grundform zur Anwendung passen.
Wichtig ist die Grenze:
- Ein Schema kann prüfen, ob
quantityeine Zahl ist. - Es kann nicht allein prüfen, ob in der PDF tatsächlich 12 statt 21 Stück stehen.
- Es kann erzwingen, dass eine Kunden-ID wie erwartet dargestellt wird.
- Es kann nicht allein beweisen, dass diese ID zum Besteller gehört.
Darum kombiniert die Anwendung strukturelle Validierung mit Kandidatensperre, Mindestbedingungen und Prüfansicht. „Valides JSON“ ist ein Schnittstellenmerkmal, kein Qualitätsurteil über den Auftrag.
Projektbeleg: privater Repository-Snapshot, Commit 3655d58, geprüft am 15. September 2026.
Was ein Wechsel zu Vertex AI technisch bedeuten würde
Der Snapshot nutzt @ai-sdk/google mit API-Key. Der offizielle Vertex-Provider des AI SDK ist ein eigenes Paket und benötigt Google-Cloud-Authentifizierung sowie Angaben zu Projekt und Region. Die vorhandene Provider-Schnittstelle begrenzt den Umbau, macht ihn aber nicht zu einer reinen Änderung einer Umgebungsvariable.
Human-in-the-loop: nicht alles manuell, aber jede Wirkung verantwortet
Human-in-the-loop bezeichnet hier einen Betriebsmodus, in dem ein benannter Mensch den Originalbeleg und den KI-Vorschlag vergleichen, korrigieren und vor einer geschäftswirksamen Übergabe freigeben kann.
Der Assistent stellt Originalnachricht, PDF und extrahierte Felder in einer Prüfliste gegenüber. Kunden, Artikel, Mengen und weitere Angaben lassen sich korrigieren. Der Bearbeitungszustand bleibt nachvollziehbar.
Im aktuellen Code existieren zwei Betriebsmodi:
1. Kontrollierter Vorschlagsmodus
Ein Mensch prüft und gibt frei. Dieser Modus eignet sich für den Start, für neue Absender, ungewöhnliche Dokumente und Fälle mit hohem Fehlerschaden.
2. Bedingte automatische Weitergabe
Eine pro Organisation zuschaltbare Automatik kann vollständig erkannte Fälle oberhalb einer einstellbaren Schwelle weitergeben. Eine hohe Modellkonfidenz allein genügt nicht: Kunde und Positionen müssen zugeordnet sein, Mengen müssen plausibel vorhanden sein, die Halluzinationssperre darf nichts entfernt haben und manuelle Korrekturen schließen den automatischen Weg aus.
Ob diese Automatik in Produktion aktiviert ist, belegt der Snapshot nicht. Deshalb wäre „vollautomatische Auftragserfassung im Einsatz“ eine unzulässige Behauptung. Automatisierung ist kein Alles-oder-nichts-Schalter: Sie wird pro Risiko- und Fallklasse verdient. Wie Schattenbetrieb, überwachte Freigabe und ein späteres Automatik-Gate gemessen werden, zeigt der Pilotabschnitt weiter unten.
Projektbeleg: privater Repository-Snapshot, Commit 3655d58, geprüft am 15. September 2026. Die Automatik ist im Datenmodell standardmäßig deaktiviert.
Der ERP-Schreibpfad braucht mehr Schutz als der Modellaufruf
Xentral ist das Führungssystem für Kunden, Artikel, Preise und Aufträge. Die anwendungseigene PostgreSQL-Datenbank spiegelt Stammdaten für die Suche und hält die eigenen Prozessdaten. Die Xentral API bietet dafür Ressourcen und dokumentiert unter anderem die V3-Auftragsanlage.
Ein freigegebener Vorschlag darf trotzdem nicht direkt als beliebiger API-Aufruf enden. Der untersuchte Code bündelt den Schreibweg und prüft davor mehrere Bedingungen:
- globaler Schreibschalter,
- richtiger Bearbeitungszustand,
- vollständiger Kunde und vollständige Positionen,
- organisationsrichtige Stammdaten,
- lokaler Schutz gegen parallele Doppelverarbeitung,
- Remote-Suche nach einer bereits vorhandenen externen Auftragskennung,
- nachvollziehbare Status- und Fehlerwerte.
Löschen bleibt im Client gesperrt. Schreibende Aufrufe werden nicht blind automatisch wiederholt. Das ist wichtig, weil viele ERP-APIs keinen universellen Idempotency-Key anbieten und ein Timeout nicht verrät, ob der Auftrag vor dem Abbruch bereits entstanden ist.
Projektbeleg: privater Repository-Snapshot, Commit 3655d58, geprüft am 15. September 2026. Globale Xentral-Schreibzugriffe und die automatische Weitergabe sind standardmäßig deaktiviert.
Der manuelle Rückfallweg gehört zur Architektur
Für den Betrieb empfiehlt sich ein Rückfallplan, damit der Auftragseingang auch bei einem Ausfall von KI, Postfachabruf oder ERP-Anbindung weiterarbeiten kann. Er sollte einen dokumentierten manuellen Erfassungsweg, einen benannten Verantwortlichen samt Vertretung für die Fehlerwarteschlange und ein Verfahren für unklare Schreibvorgänge vorsehen: Erst in Xentral abgleichen, ob ein Auftrag trotz Timeout angelegt wurde, dann gezielt fortsetzen. Nach einem Neustart sollten offene und bereits beanspruchte Vorgänge geprüft werden. Reaktions- und Wiederanlaufziele sollten vor dem Pilot vereinbart werden; die Automatik sollte ausgeschaltet bleiben, bis diese Abläufe stabil funktionieren.
Die Lehre ist übertragbar: Je realer die Wirkung, desto deterministischer muss der letzte Meter sein. Das Modell darf interpretieren. Ob, wohin und wie oft geschrieben wird, entscheidet klassische Software anhand überprüfbarer Zustände.
Zwei Firmenkontexte, eine Anwendung: Trennung ist Teil des Produkts
Im Projekt sind zwei Firmenkontexte mit getrennten Postfächern und getrennten Xentral-Zugängen angelegt. Die Anwendung ordnet fachliche Datensätze einer Organisation zu und prüft bei jeder Anfrage die aktuelle Mitgliedschaft. Eine aktive Organisations-ID in einer Sitzung gilt nicht allein als Zugriffsnachweis. Der zweite Firmenname ist für diese technische Aussage unerheblich und bleibt unveröffentlicht.
Das klingt nach technischer Hygiene, ist aber geschäftlich zentral. Eine vergessene Organisationsbedingung könnte nicht nur eine falsche Ansicht erzeugen. Sie könnte Kundendaten, Artikelnummern oder Aufträge zwischen Firmenkontexten vermischen.
Der Snapshot belegt unter anderem:
- organisationsgebundene Repository-Zugriffe,
- zusammengesetzte Eindeutigkeiten mit Organisationsbezug,
- getrennte Xentral-Zugänge je Organisation,
- anwendungsseitige AES-256-GCM-Verschlüsselung dieser Xentral-Tokens.
Er belegt nicht, dass sämtliche gespeicherten E-Mail- und PDF-Inhalte zusätzlich auf Anwendungsebene verschlüsselt sind. Auch Hosting, Festplattenverschlüsselung, Backups, Schlüsselbetrieb und Zugriffsprotokolle müssen separat geprüft werden.
Projektbeleg: privater Repository-Snapshot, Commit 3655d58, geprüft am 15. September 2026. Der Codebeleg ersetzt keinen Infrastruktur- oder Berechtigungstest im realen Betrieb.
Datenschutz beim Verarbeiten von Bestellmails mit Vertex AI
Der im Snapshot implementierte Extraktionspfad übermittelt bei Ausführung Absender, Betreff, E-Mail-Text, native PDF-Inhalte, Regeln beziehungsweise Korrekturkontext sowie Kunden- und Artikelkandidaten an die Gemini Developer API. Für Embeddings können außerdem ausgewählte Produkt- und Kundendaten an denselben Provider gehen. Welche produktiven Vertrags-, Regions-, Aufbewahrungs- und Logging-Einstellungen tatsächlich gelten, wurde im Repository-Review nicht nachgewiesen. Vor einer Veröffentlichung als reale Referenz müssen diese Punkte am laufenden System geprüft werden.
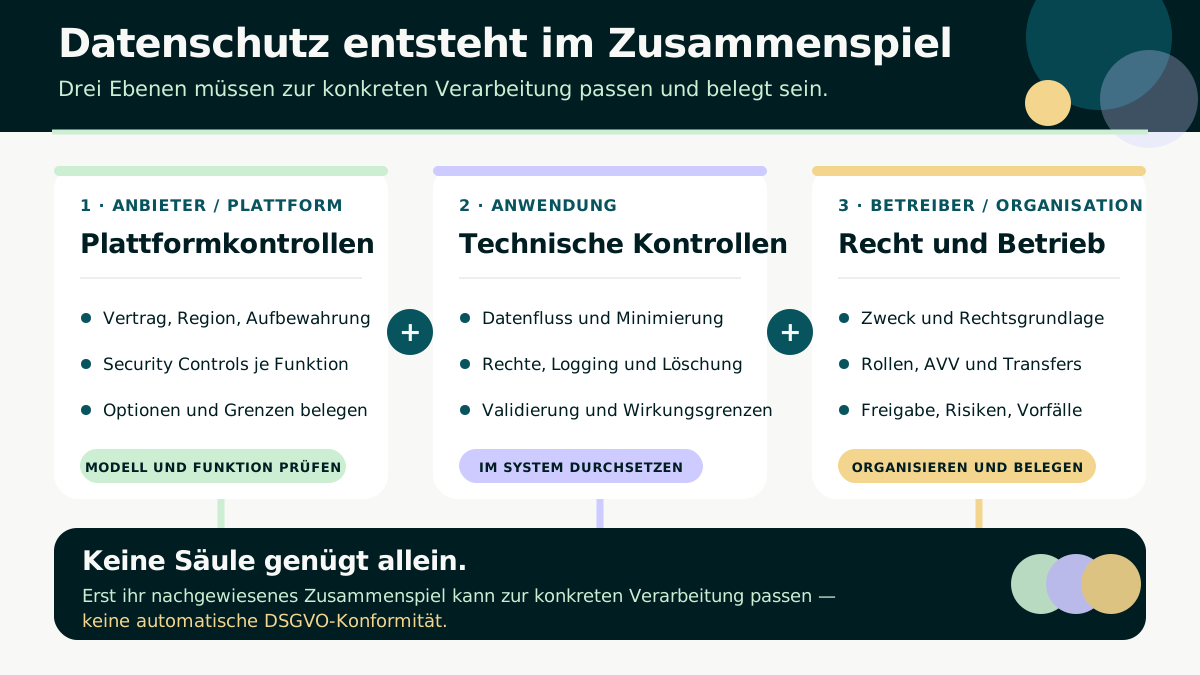
Die Aussage „Wir verwenden Vertex AI, daher ist die KI DSGVO-konform“ wäre auch nach einer Migration zu kurz. Die DSGVO bewertet eine konkrete Verarbeitung. Nach Artikel 5 gehören dazu unter anderem Zweckbindung, Datenminimierung, Richtigkeit, Speicherbegrenzung und Sicherheit. Für Auftragsverarbeiter ist Artikel 28 relevant, für technische und organisatorische Maßnahmen Artikel 32. Den allgemeinen Infrastrukturvergleich zwischen lokaler KI und Cloud-Plattformen vertieft der Beitrag „Nur lokale KI ist DSGVO-konform?“; hier geht es um den konkreten Datenfluss von Bestellmails.
Vertex AI kann dafür wichtige Bausteine bereitstellen:
- Google stellt ein Cloud Data Processing Addendum bereit und ordnet seine Cloud-Angebote in einer GDPR-Ressource ein.
- Google dokumentiert eine Training Restriction: Kundendaten werden ohne vorherige Erlaubnis oder Anweisung nicht zum Trainieren oder Fine-Tunen verwalteter Modelle verwendet.
- Dieselbe Seite beschreibt aber auch Aufbewahrungsfälle und nötige Konfigurationen, etwa Missbrauchsüberwachung, optionale Request-/Response-Logs oder bestimmte Grounding-Funktionen. „Zero Data Retention“ ist kein Wort, das man ohne Featureprüfung übernehmen sollte.
- Vertex bietet regionale, globale und eine EU-Multiregion. Die Standortdokumentation warnt, dass ein Endpunkt allein nicht pauschal Datenresidenz oder Verarbeitung in der Region garantiert. Wer die ML-Verarbeitungsregion steuern muss, darf nicht unbesehen den globalen Endpunkt verwenden.
- Security Controls wie Datenresidenz, kundenseitig verwaltete Schlüssel, VPC Service Controls und Access Transparency hängen von Modell und Funktion ab; Preview-Modelle sind laut Übersicht ausgenommen.
Datenschutz-Check für diesen konkreten Prozess
Vor einem produktiven Go sollten mindestens diese Fragen schriftlich beantwortet sein:
- Welche Felder aus E-Mail, PDF, Kundenstamm und Historie gehen an welchen Anbieter?
- Ist der gesamte Kundenstamm im Prompt wirklich erforderlich, oder reicht ein engeres Retrieval?
- Welche Rechtsgrundlage und welche Informationspflichten gelten?
- Sind Auftragsverarbeitung, Unterauftragsverarbeiter und Transfers dokumentiert?
- Welche Region und welcher Endpunkt werden tatsächlich erzwungen?
- Welche Anbieter- und Anwendungslogs existieren, und wie lange bleiben sie?
- Wer darf Originalbelege, Vorschläge und Korrekturhistorie sehen?
- Wann werden E-Mails, PDFs, Vektoren und Auditdaten gelöscht oder anonymisiert?
- Wie werden Auskunft, Berichtigung, Löschung und Sicherheitsvorfälle bearbeitet?
- Welche Tests und Freigaben belegen, dass die dokumentierte Konfiguration auch läuft?
Das ist keine Rechtsberatung. Es ist die technische Belegliste, die eine Datenschutzprüfung erst konkret macht.
Wann ich Standardsoftware und wann ich eine individuelle Lösung prüfen würde
Eine individuelle KI-Anwendung ist sinnvoll, wenn nicht nur ein Dokument gelesen, sondern ein eigener Prozess zwischen Postfach, Stammdaten, Regeln, Prüfung und ERP abgebildet werden soll. Sie ist nicht automatisch die wirtschaftlichste Lösung.
1. Muss-Kriterien zuerst, Anbieter erst danach
| Muss-Kriterium | Nachweis bei einer Standardlösung | Nachweis bei einer individuellen Lösung |
|---|---|---|
| unterstützte Postfächer, PDFs und Sprachen | mit eigenen repräsentativen Belegen testen | als Abnahmetest festschreiben |
| Xentral-Felder, Sonderregeln und Dublettenschutz | konkrete Funktionen und Grenzen des Produkts zeigen lassen | Datenmodell, Prüfungen und Fehlerpfade spezifizieren |
| Firmen- und Berechtigungstrennung | Rollenmodell und technische Isolation belegen lassen | Organisationsgrenzen automatisiert testen |
| Menschenprüfung und Ausnahmebearbeitung | Prüfansicht, Warteschlange und Exportweg vorführen | Rollen, Zustände und manuellen Rückfallweg bauen |
| Datenschutz und Datenstandort | Vertrag, Unterauftragnehmer, Regionen, Logs und Löschung prüfen | dieselben Nachweise für jeden eingesetzten Dienst und den Eigenbetrieb liefern |
| Betrieb und Wiederanlauf | Serviceumfang, Supportzeiten und Datenexport klären | Verantwortliche, Monitoring, Backup und Wiederanlauf finanzieren |
2. Standardlösung testen oder eine belegte Lücke benennen
Eine Standardlösung ist der naheliegende erste Kandidat, wenn die eigenen Belege, Xentral-Felder, Freigaben und Firmenkontexte in ihrem Produktstandard funktionieren und geringer interner Betriebsaufwand wichtiger ist als Sonderlogik. Das sollte mit repräsentativen Dokumenten und echten Ausnahmefällen geprüft werden, nicht nur in einer Anbieterdemo.
Eine Individualentwicklung sollte erst weiterverfolgt werden, wenn dieser Test eine wesentliche Lücke zeigt oder eigene Regeln, Korrekturwissen und risikogestufte Freigaben einen nachweisbaren strategischen Wert haben. „Individuell“ ist kein Qualitätsmerkmal, sondern eine Investition mit eigener Betriebsverantwortung.
3. Die Optionen mit derselben Business-Case-Rechnung vergleichen
- Ist-Kosten pro Monat: Auftragsvolumen pro Monat × (Bearbeitungszeit + Nacharbeitszeit je Auftrag in Stunden) × Vollkosten-Stundensatz + erwartete Fehlerfolgekosten pro Monat + fixe Prozesskosten pro Monat.
- TCO der Standardlösung: Einführung und Datenbereinigung + Lizenzen + Integrationen und Updates + interner Betrieb + verbleibende Prüf-, Ausnahme- und Fehlerkosten.
- TCO der individuellen Lösung: Entwicklung und Datenbereinigung + Modell und Infrastruktur + Integrationen und Updates + Monitoring, Backup und Bereitschaft + Datenschutzdokumentation + verbleibende Prüf-, Ausnahme- und Fehlerkosten + erwarteter Wechselaufwand.
- Vergleich: Ist-Prozess, Standardsoftware und Individualentwicklung über denselben Zeitraum und in derselben Währung mit denselben Lohn-, Volumen-, Risiko- und Wachstumsannahmen rechnen.
Erst wenn Prüfzeit, Korrekturquote und Fehlerfolgen im Pilot gemessen sind, werden aus Annahmen belastbare Eingaben. Niedrige Modellkosten machen den Gesamtprozess nicht automatisch günstig – und höhere technische Kosten schließen einen tragfähigen Business Case nicht automatisch aus.
Ein Pilot, der mehr beantwortet als „Die Demo funktioniert“
Ein guter Pilot braucht echte Varianz, aber keine unkontrollierte ERP-Wirkung. Ich würde ihn in vier Schritten aufbauen.
Verantwortlichkeit vor dem Start
| Rolle | Verantwortung im Pilot |
|---|---|
| Geschäftsführung | Budget, akzeptabler Fehlerschaden und finale Investitionsentscheidung |
| Prozessverantwortung im Auftragseingang | Sollprozess, Fallklassen, Qualitätsziele und fachliche Abnahme |
| tägliche Prüfung plus Vertretung | Vorschläge kontrollieren, Korrekturen erfassen und Fehlerwarteschlange bearbeiten |
| IT oder Integration | Postfach, Datenbank, Xentral, Monitoring, Backup und Wiederanlauf |
| Datenschutzverantwortung | Datenfluss, Rechtsgrundlage, Verträge, Löschung und Betroffenenprozesse |
| externer Umsetzungspartner | technische Umsetzung, Tests, Dokumentation und Übergabe – nicht die unternehmerische Risikofreigabe |
Folgende Zuordnung ist ein konservativer Ausgangspunkt und muss vor dem Pilot namentlich bestätigt werden. Jede Zeile hat genau einen Entscheidungseigentümer; die Mitwirkung anderer Rollen ersetzt ihn nicht.
| Entscheidungsgate | Entscheidungseigentümer | Erforderliche Mitwirkung |
|---|---|---|
| Pilotstart | Geschäftsführung | Prozessverantwortung, IT und Datenschutz liefern die Entscheidungsgrundlage |
| Aktivierung einer Automatik | Geschäftsführung | Prozessverantwortung weist Qualitätsgate nach; IT und Datenschutz bestätigen ihre Freigabepunkte |
| sofortiger Betriebsstopp | Prozessverantwortung | tägliche Prüfung und IT melden Auslöser und sichern den manuellen Weg |
| Reaktion auf einen Sicherheitsvorfall | IT- oder Sicherheitsverantwortung | Datenschutz und Geschäftsführung werden nach Vorfallplan eingebunden |
| finales Go oder No-Go | Geschäftsführung | Prozessverantwortung legt Messwerte, Risiken und TCO-Vergleich vor |
Schritt 1: Prozess und geprüfte Sollwerte
- repräsentative, rechtlich freigegebene Bestelltypen erfassen,
- sensible Daten minimieren oder für Tests synthetisch ersetzen,
- Sollwerte für Kunde, Artikel, Menge, Einheit und Bestellnummer festlegen,
- Fehlerschaden und Abbruchkriterien je Feld bestimmen.
Schritt 2: Schattenbetrieb
- E-Mails verarbeiten, aber nichts ins ERP schreiben,
- jede Modellantwort gegen die geprüften Sollwerte vergleichen,
- Ausfälle und nicht zuordenbare Fälle als eigene Kategorie messen,
- Prompt-, Retrieval- und Stammdatenfehler getrennt klassifizieren.
Schritt 3: Überwachte Freigabe
- Originalbeleg und Vorschlag nebeneinander prüfen,
- Korrekturen strukturiert erfassen,
- Prüfzeit pro Auftrag messen,
- Dubletten-, Berechtigungs- und Fehlerpfade absichtlich testen.
Schritt 4: Investitionsentscheidung
| Messgröße | Was sie beantwortet |
|---|---|
| Anteil korrekt erkannter Bestellungen | Erkennt das System den richtigen Eingang? |
| Kunden- und Artikeltreffer je Feld/Position | Wo entstehen fachliche Zuordnungsfehler? |
| Mengen- und Einheitentreffer | Drohen operative Fehlmengen oder Gebindefehler? |
| Anteil ohne Korrektur freigabefähiger Vorschläge | Wie viel echte Entlastung ist möglich? |
| Median und Streuung der Prüfzeit | Wird Arbeit zuverlässig kürzer oder nur anders? |
| Fehlweitergaben und Dubletten | Bleibt der geschäftswirksame Pfad innerhalb der Risikogrenze? |
| Kosten je korrekt freigabefähigem Vorschlag | Wie verhalten sich Modell-, Infrastruktur- und Betriebsaufwand? |
| Alter offener Fehlerfälle | Funktioniert die Ausnahmeorganisation im Alltag? |
Zielwerte dürfen nicht nachträglich an das Ergebnis angepasst werden. Sie gehören vor den Pilot.
Entscheidung am Ende von Schritt 4:
- Go: Qualitäts- und Risikoziele sind erreicht, Datenschutz- und Betriebsnachweise vollständig, Verantwortliche benannt.
- Pilot verlängern: Nutzen ist sichtbar, aber eine klar begrenzte Fallklasse braucht mehr Daten oder bessere Stammdaten.
- Klärung: Verträge, Region, Löschung, Berechtigungen oder ERP-Wirkung sind noch offen.
- Stopp: Kritische Fehlweitergaben, unbeherrschbare Ausnahmequote oder kein belastbarer wirtschaftlicher Vorteil.
Der Pilot ist erfolgreich, wenn er eine belastbare Entscheidung ermöglicht. Das kann auch ein begründetes Nein zur Automatik sein.
Häufige Fragen
Welche Datenschutzfragen entstehen bei Bestellmails in Vertex AI?
Vertex AI ist nicht pauschal „DSGVO-konform“. Die konkrete Verarbeitung muss die DSGVO erfüllen. Der Betreiber muss insbesondere Zweck, Rechtsgrundlage, Datenminimierung, Region, Aufbewahrung, Zugriffe und Betroffenenprozesse verantworten; Googles Dokumentation zu Aufbewahrung und nötigen Konfigurationen muss für die tatsächlich verwendeten Funktionen geprüft werden.
Was ist RAG bei der Auftragserfassung?
Im geprüften privaten Repository-Snapshot auf Commit 3655d58 holt die Anwendung vor der Extraktion Kunden- und Artikelkandidaten aus echten Stammdaten. Das Modell erhält damit betrieblichen Kontext und wählt aus einer kontrollierten Menge. Es wird dadurch nicht neu trainiert, und Fehler bleiben möglich. Google beschreibt das allgemeine, vom konkreten Projekt unabhängige Muster in seiner RAG-Architekturübersicht.
Kann eine KI Aufträge direkt in ein ERP schreiben?
Technisch ja; Xentral dokumentiert beispielsweise eine API für die Anlage von Aufträgen. Ob eine KI diesen Pfad auslösen darf, ist eine Risiko- und Betriebsentscheidung. Mindestens Zustandsprüfung, Vollständigkeit, erlaubte IDs, Dublettenschutz, Berechtigungen, Auditspur und ein Notaus gehören davor. Bei hohem Fehlerschaden sollte zunächst ein Mensch freigeben.
Reicht strukturierte JSON-Ausgabe gegen Halluzinationen?
Nein. Strukturierte Ausgaben im AI SDK können Aufbau und Datentypen an ein Schema binden. Eine formal gültige Kunden- oder Artikel-ID kann fachlich trotzdem falsch sein. Deshalb braucht es kontrollierte Kandidaten, Nachvalidierung und risikogerechte Freigabe.
Wie viel kostet eine solche Lösung?
Ohne Volumen, Dokumentlängen, Modell, Trefferquote, Prüfzeit, Integrationen und Betriebsanforderungen ist eine seriöse Zahl nicht möglich. Entscheidend ist nicht der Preis eines Modellaufrufs, sondern die Gesamtkosten je korrekt freigabefähigem Auftrag.
Fazit: Das Modell ist nicht der Mitarbeiter, der Prozess ist es
Der WG-Sales-Entwicklungsstand zeigt eine robuste Richtung: unstrukturierte Bestellmails werden nicht blind in ein ERP übersetzt. Stammdaten begrenzen die Auswahl, strukturierte Ausgaben schaffen eine Schnittstelle, klassische Prüfungen fangen bekannte Fehlerklassen ab und Menschen behalten einen kontrollierten Entscheidungspfad.
Er zeigt ebenso offen, was noch zu beweisen ist: produktive Konfiguration, Vertex-Migration, Datenschutzfreigabe, Datenminimierung, messbare Genauigkeit und wirtschaftlicher Nutzen. Diese offenen Punkte zu benennen schwächt das Projekt nicht. Es trennt belastbare Digitalisierung von Werbeversprechen.
Ein sinnvoller nächster Prüfpunkt: Prozess-Discovery
Benötigte Eingaben: monatliches Auftragsvolumen, anonymisierte oder rechtlich freigegebene Beispielbelege, beteiligte Systeme, heutige Bearbeitungs- und Nacharbeitszeit, bekannte Fehlerfolgen und ausdrücklich ausgeschlossene Fallklassen.
Ergebnis: Prozess- und Datenflusskarte, erste Risikoliste, Vergleich von Ist-Prozess, Standardsoftware und Individualansatz, belastbare Aufwandsspanne sowie ein Pilotplan mit Messgrößen und Abbruchkriterien.
Entscheidung am Checkpoint: kein Pilot, Test einer Standardlösung oder klar begrenzter Individualpilot. Das Ergebnis ist nicht automatisch ein Umsetzungsauftrag.
Wenn Sie diesen Prüfpunkt für Ihren Auftragseingang durchführen möchten, können Sie eine Prozess-Discovery vereinbaren. Weiterführenden Umsetzungskontext finden Sie unter KI für Unternehmen und Digitalisierung im Mittelstand.
Quellen und Stand
- WG Salesmanagement: Unternehmen und Leistungsprofil
- Datenschutz-Grundverordnung, konsolidierter Text
- Google Cloud: GDPR
- Google Cloud Data Processing Addendum
- Vertex AI: Zero Data Retention und dokumentierte Aufbewahrungsfälle
- Vertex AI: Standorte und Endpunkte
- Vertex AI: Security Controls für generative KI
- Google Cloud: Dokumentverständnis
- Google Cloud: RAG-Architektur mit generativer KI
- AI SDK: Google Provider
- AI SDK: Google Vertex Provider
- AI SDK: strukturierte Datengenerierung
- Microsoft Graph: Change Notifications
- Microsoft Graph: Delta-Abfrage für Nachrichten
- Xentral API: Einführung
- Xentral API: Auftrag über V3 erstellen
- pgvector: Vektor- und hybride Suche in PostgreSQL
- OWASP: LLM Prompt Injection Prevention
Technischer Stand: privater Repository-Snapshot auf Commit 3655d58 vom 8. September 2026, geprüft am 15. September 2026. Der Beitrag beschreibt einen Entwicklungsstand, keine Zertifizierung und keine Rechtsberatung. Links und Anbieterangaben wurden am 15. September 2026 geprüft.
- KI-Auftragserfassung
- Bestellmails
- RAG
- Google Vertex AI
- Xentral
- KMU
Weitere Beiträge
Mein Web-Stack für KMU: statisch starten, dynamisch ergänzen
Warum Wogenfels KMU-Websites mit Astro statisch beginnt, Dynamik per Hono abgrenzt, Persistenz nur vorbereitet und Qualität automatisiert prüft.
Hermes Agent oder n8n? So bauen KMU einen kontrollierten KI-Mitarbeiter
Hermes Agent oder n8n? Der Vergleich zeigt KMU, wann ein Agent, ein fester Workflow oder eine kontrollierte Kombination sinnvoll ist.
Welche KI-Modelle laufen lokal? Speicher, Kosten und Einsatz für KMU
Welche KI-Modelle laufen lokal? Ein KMU-Leitfaden zu Modellgrößen, RAM/VRAM, Quantisierung, sinnvollen Aufgaben, Hardwarekorridoren und TCO.