
BlogKünstliche Intelligenz
Nur lokale KI ist DSGVO-konform? Der Faktencheck für KMU
Von Dominik Pototschnig15 Min.

In diesem Beitrag
Ein Server im eigenen Büro löst weder Rechtsgrundlage noch Zugriffsrechte, Löschung und Sicherheit. Lokale KI ist deshalb nicht automatisch DSGVO-konform. Und eine EU-Cloud ist genauso wenig automatisch konform. Entscheidend ist die gesamte Verarbeitung – und die lässt sich prüfen, bevor Sie in eigene GPUs investieren.
Kurzantwort: Die DSGVO verlangt nicht pauschal, dass KI lokal betrieben wird; die österreichische Datenschutzbehörde beschreibt sie als technologieneutral. Maßgeblich sind Zweck und Rechtsgrundlage, Daten, Rollen und Verträge, Speicher- und Löschregeln, Sicherheit, Empfänger, Übermittlungen und Risiken der konkreten Verarbeitung. Lokaler Betrieb kann externe Datenwege reduzieren. Ein Konformitätsnachweis ist er allein aber ebenso wenig wie die Auswahl einer EU-Cloudregion.
Das ist keine Freigabe für beliebige Cloud-KI. Zwischen einem kostenlosen Consumer-Chat und einer kontrollierten Unternehmensumgebung auf Amazon Bedrock, Google Vertex AI oder Microsoft Foundry liegen technisch und vertraglich Welten. Genauso liegen zwischen einem Laptop mit lokalem Modell und einer sauber betriebenen On-Premises-Plattform Welten.
In diesem Beitrag bedeutet lokale KI, dass nicht nur die Modellberechnung, sondern die betrachtete Datenkette unter eigener oder vertraglich eigener Kontrolle läuft. Cloud-KI meint eine vom Unternehmen konfigurierte, verwaltete Unternehmensplattform – keinen frei zugänglichen Chatdienst. Hybrid ist eine dokumentierte Aufteilung beider Betriebsformen; auch ihre Übergaben gehören in den Datenfluss.
Für ein KMU ist deshalb nicht die Frage „Cloud oder Datenschutz?“ entscheidend. Die bessere Frage lautet:
Welche Architektur erfüllt für diesen konkreten Anwendungsfall die datenschutzrechtlichen, technischen und wirtschaftlichen Anforderungen?
Stand der Rechts- und Produktquellen: 15. September 2026. Produktnamen, Regionen, Funktionen und Vertragsstände können sich ändern. Dieser Beitrag betrachtet schwerpunktmäßig die DSGVO und ersetzt keine rechtliche Einzelfallprüfung.
Lokale KI und DSGVO: Was tatsächlich geprüft werden muss
Die Verordnung schreibt kein bestimmtes Hostingmodell vor. Sobald personenbezogene Daten verarbeitet werden, muss das Unternehmen die Anforderungen der konkreten Verarbeitung erfüllen:
- Zweck und Rechtsgrundlage: Für die Verarbeitung braucht es einen bestimmten Zweck und eine passende Rechtsgrundlage. Die Managementfrage lautet: Welche Daten benötigt die KI für genau welche Aufgabe – und auf welcher Grundlage dürfen sie verarbeitet werden? (Art. 5 und 6 DSGVO)
- Datenminimierung: Es dürfen nur die für den Zweck nötigen Daten verarbeitet werden. Braucht das Modell Namen, Kontaktdaten oder vollständige Dokumente – oder reichen nachweislich nicht personenbezogene, tatsächlich anonymisierte oder reduzierte Testdaten? (Art. 5 DSGVO)
- Rollen und Vertrag: Beauftragt ein Unternehmen einen Anbieter mit der Verarbeitung, müssen die tatsächlichen Rollen und die Anforderungen des Art. 28 vertraglich abgebildet sein. Der EDSA-Leitfaden für KMU erklärt, welche Aufgaben auch mit einem Dienstleister beim Unternehmen bleiben.
- Speicherung und Löschung: Speicherbegrenzung und Löschkonzept müssen Eingaben, Ausgaben, Protokolle, Embeddings, Zustände und Backups abdecken. Welche Daten entstehen an welcher Stelle, wie lange bleiben sie dort, und wie werden sie gelöscht oder zurückgegeben? (Art. 5 und 28 DSGVO)
- Sicherheit und Zugriff: Das Schutzniveau muss zum Risiko passen. Wer darf auf Modelle, Daten, Schlüssel und Logs zugreifen, und wie sind Berechtigungen, Verschlüsselung, Protokollierung, Netzgrenzen und Notfälle geregelt? (Art. 25 und 32 DSGVO)
- Regionen, Empfänger und Übermittlungen: Internationale Übermittlungen und Weiterübermittlungen brauchen die Voraussetzungen des Kapitels V. Welche Unterauftragsverarbeiter, Supportzugriffe und Transfermechanismen bestehen neben der gewählten Region? (Kapitel V DSGVO)
- Risikoprüfung und DSFA: Ergibt die Vorprüfung ein voraussichtlich hohes Risiko, ist vor Beginn der Verarbeitung eine Datenschutz-Folgenabschätzung durchzuführen. Nicht jede KI-Anwendung erreicht diese Schwelle; die österreichische Datenschutzbehörde erläutert sie.
Diese Prüfungen gelten unabhängig davon, ob die GPU im eigenen Rack, in einem Rechenzentrum oder in einer verwalteten Cloud läuft. Der Standort ist wichtig. Er ist nur nicht die ganze Antwort.
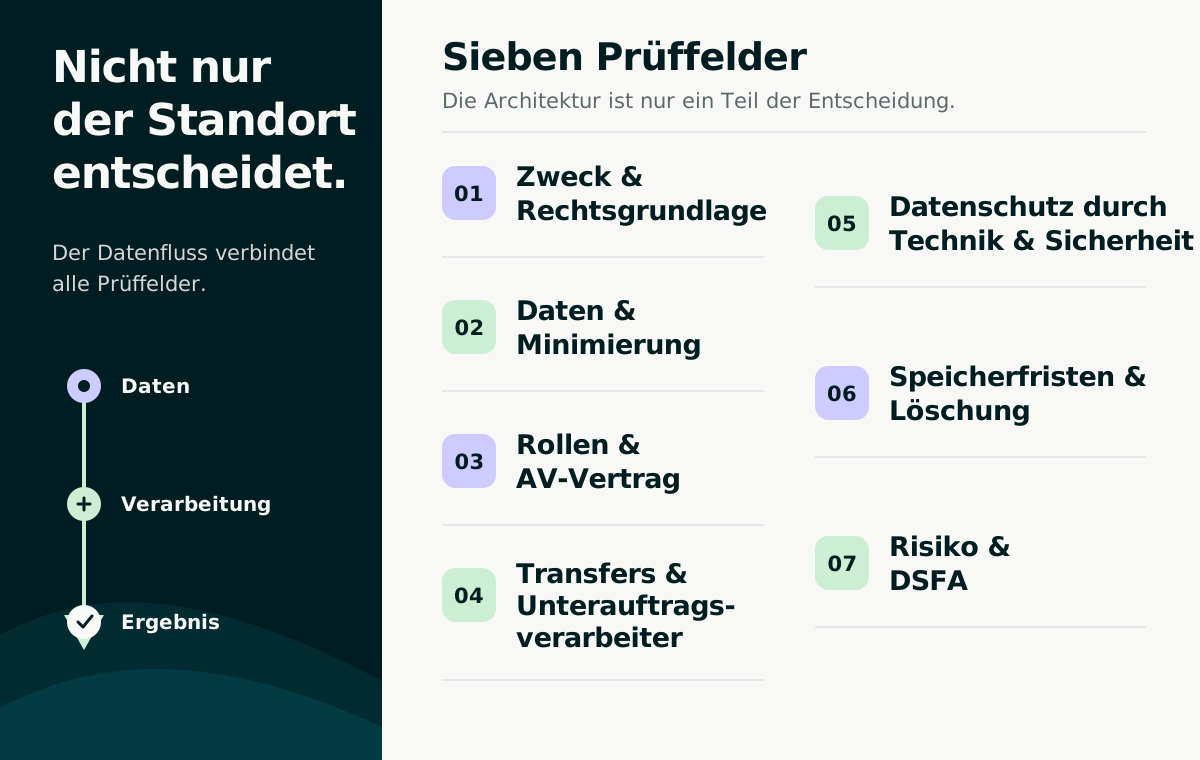
Entscheidungsmodell von Wogenfels auf Basis der DSGVO-Prüffelder, Quellenstand 15. September 2026; keine rechtliche Einzelfallfreigabe.
Was lokale KI löst – und was nicht
Lokaler Betrieb hat reale Vorteile. Wenn Modell, Anwendung, Datenbank, Monitoring und Administrationszugriff tatsächlich in einer kontrollierten Umgebung bleiben, können externe Empfänger und Übermittlungspfade reduziert werden. Echte Offline- oder No-Egress-Anforderungen können eine lokale Architektur besonders prüfenswert machen. Dasselbe gilt, wenn eine stabile hohe Last oder eine harte Latenzgrenze vor Ort belegt ist.
Aber „lokal“ ist keine Eigenschaft, die man einmal anklickt. Auch ein lokales Modell kann:
- personenbezogene Daten ohne passende Rechtsgrundlage verarbeiten,
- zu viele Daten erhalten oder sie zu lange aufbewahren,
- durch zu breite Berechtigungen, fehlende Updates oder schwache Backups gefährdet sein,
- Telemetrie, Lizenzprüfungen oder externe Werkzeuge aufrufen,
- vertrauliche Inhalte in Logs oder Vektordatenbanken vervielfachen,
- und Ausgaben erzeugen, die fachlich oder rechtlich nicht ungeprüft verwendet werden dürfen.
Hinzu kommt der Betrieb: Hardware beschaffen, Kapazität planen, Ausfälle abfangen, Modelle und Laufzeit aktualisieren, Schwachstellen schließen, Monitoring aufsetzen und Vertretung organisieren. Wer diese Aufgaben übernimmt, gewinnt Kontrolle – übernimmt aber auch Verantwortung.
Die belastbare Aussage lautet daher: Lokal kann bestimmte Risiken und Abhängigkeiten reduzieren. Ob die gesamte Anwendung datenschutzgerecht ist, entscheidet sich weiterhin anhand ihres Datenflusses und ihres Betriebs.
Warum eine EU-Region allein nicht reicht: drei Plattformen im Prüfraster
Amazon Bedrock, Google Vertex AI – heute Gemini Enterprise Agent Platform – und Microsoft Foundry sind keine DSGVO-Zertifikate. Sie sind Werkzeugkästen, in denen sich Verträge, Regionen, Modellpfade, Aufbewahrung und technische Kontrollen auswählen und dokumentieren lassen. Die folgende Tabelle beschreibt dokumentierte Möglichkeiten, keine Freigabe; jede Zelle steht unter dem Vorbehalt des konkreten Modells, der Region, API, Funktion und Vertragsfassung.
| Prüffeld | Amazon Bedrock | Google Vertex AI / Gemini Enterprise Agent Platform | Microsoft Foundry |
|---|---|---|---|
| Rolle und Vertrag | AWS-DPA; Kundenrolle und Servicebedingungen prüfen | Google-CDPA; dienstspezifische Bedingungen mitprüfen | Microsoft-DPA; Produkt- und Preview-Bedingungen ergänzen |
| Modellpfad | Bedrock-Deployment und optionale externe Werkzeuge trennen | Google-, Drittanbieter- und offene Modellpfade unterscheiden | „Models sold by Azure“ nicht mit Partner-/Community-Modellen vermischen |
| Region und Verarbeitung | In-Region, geografisch oder global; je Modell | EU-Multiregion, regionaler („locational“) oder globaler Endpunkt; je Modell/Funktion | global, Data Zone oder Geografie; je Deployment/Modell |
| Training und Aufbewahrung | Modellanbieterzugriff, Retention-Modus und Modell getrennt prüfen | Trainingseinschränkung und featureabhängige Aufbewahrung getrennt prüfen | „Models sold by Azure“, gespeicherte Funktionen und Abuse Monitoring getrennt prüfen |
| Privater Netzwerkpfad | PrivateLink und Endpoint Policies | VPC Service Controls plus privater API-Zugang | Private Endpoints/Private Link und VNet |
| Eigene Evaluation | eigene Prompts und Kriterien | Model Garden und datenbasierter Evaluationsdienst | Katalog, Benchmarks und eigene Tests |
| Häufigster Denkfehler | „Kein Modellanbieterzugriff“ mit „keine Speicherung“ gleichsetzen | EU-Endpunkt oder „kein Training“ als Gesamtfreigabe lesen | Zusagen für „Models sold by Azure“ auf alle Angebote übertragen |
Offizielle Grundlagen zur Tabelle: AWS-DPA, Bedrock-Datenschutz, Google-CDPA, Google Data Residency, Google Model Garden und Evaluation, Microsoft-DPA, Microsoft-Datenschutz für Models sold by Azure und Microsoft-Modellbenchmarks.
Für die Geschäftsführung stecken dahinter vier einfache Nachweisfragen:
- Retention heißt Aufbewahrung: Welche Eingaben, Ausgaben und Logs bleiben wie lange bestehen?
- Abuse Monitoring ist die Prüfung auf missbräuchliche Nutzung: Welche Inhalte werden dafür automatisiert oder durch Menschen geprüft?
- PrivateLink, VPC und VNet beschreiben private Netzwerkpfade: Kann die IT belegen, welche Dienste trotzdem öffentlich oder extern erreichbar sind?
- Data Zone oder EU-Endpunkt beschreibt nur einen Teil des Ortsbezugs: Was gilt getrennt für Speicherung, Modellberechnung beziehungsweise Routing, Support und Zusatzfunktionen?
Amazon Bedrock: Routing und Retention nicht vermischen
AWS beschreibt für Bedrock ein Shared-Responsibility-Modell: AWS schützt die Infrastruktur; das Unternehmen verantwortet Inhalte, Identitäten und Konfiguration. AWS sagt für den dokumentierten Bedrock-Deployment-Pfad, dass Modellanbieter keinen Zugriff auf Bedrock-Logs, Prompts oder Completions haben. Die Retention-Dokumentation zeigt zugleich, dass Aufbewahrung von Modellen und Konfiguration abhängen kann. „Kein Modellanbieterzugriff“ bedeutet daher nicht „keine Speicherung“.
Beim Ort unterscheidet AWS In-Region-, geografisches und globales Routing; die Verfügbarkeit hängt vom Modell ab. Ein privater Zugriff lässt sich mit AWS PrivateLink einrichten. Abhängige Dienste und ausgehende Verbindungen bleiben Teil des Datenflusses. Für einen Pilot dokumentiert AWS Modellvergleich mit eigenen Prompts und Kriterien, ohne damit einen bestimmten Preis oder eine Eignung für den eigenen Fall zu versprechen.
Google Vertex AI: kein Training ist nicht keine Speicherung
Google führt die frühere Vertex AI Platform laut seiner Übersicht der Namensänderungen als Gemini Enterprise Agent Platform weiter. Die Google-CDPA regelt unter anderem Rollen, Löschung, Unterauftragsverarbeiter und Transfers. Für verwaltete Modelle sagt Google, Kundendaten ohne vorherige Erlaubnis oder Weisung nicht zum Training oder Fine-Tuning zu verwenden. Laut Zero-Data-Retention-Dokumentation können Abuse Monitoring, Grounding, Logging und zustandsbehaftete Funktionen dennoch eigene Speicherregeln haben.
Die Residency-Dokumentation trennt Datenspeicherung und ML-Modellberechnung. Ein EU-Endpunkt kann die Modellberechnung auf EU-Mitgliedstaaten begrenzen; ein globaler Endpunkt bietet diese regionale Isolation nicht. Das gilt modell- und funktionsabhängig. VPC Service Controls und private API-Pfade können den Zugriff begrenzen. Die Plattform bündelt Google-, Drittanbieter- und offene Modelle; „offen“ bedeutet nicht automatisch Open Source, weshalb Lizenz und Hostingpfad je Modell zu prüfen sind.
Wie diese Prüflogik bei einem konkreten Bestellmail-Workflow mit kontrollierter ERP-Übergabe aussieht, zeigt die Architektur-Fallstudie zur KI-gestützten Verarbeitung von Bestellmails.
Microsoft Foundry: die Modellkategorie entscheidet mit
Microsoft macht bestimmte Datenschutz- und Nicht-Training-Zusagen ausdrücklich für Models sold by Azure. Diese Zusagen dürfen nicht auf alle Partner- und Community-Modelle übertragen werden; deren Modellkarten und Bedingungen sind gesondert zu prüfen. Die Deployment-Übersicht stellt die unterschiedlichen Wege gegenüber. Microsoft erläutert außerdem, dass zustandsbehaftete Funktionen Inhalte speichern können und markierte Prompts oder Ausgaben im Abuse Monitoring automatisiert und fallweise menschlich geprüft werden können.
Foundry unterscheidet globale, Data-Zone- und geografiebezogene Deployments; nicht jedes Modell unterstützt jeden Typ. Private Link schafft einen privaten Zugriffspfad; der öffentliche Zugriff muss separat deaktiviert oder begrenzt werden. Externe Werkzeuge brauchen eine eigene Betrachtung. Selbst innerhalb der EU Data Boundary dokumentiert Microsoft begrenzte fortbestehende Transfers und Remote-Zugriffe. Benchmarks und Kataloge helfen bei der Vorauswahl, ersetzen aber keinen Test mit dem eigenen Workload.
Das gemeinsame Muster lautet nicht „überall dasselbe“. Für jede Option sind Speicherort, Ort der Modellberechnung beziehungsweise des Routings, Supportzugriffe, Unterauftragsverarbeiter und Feature-Speicher getrennt nachzuweisen.
Erst pilotieren, dann Hardware kaufen
Eigene Hardware bindet Kapital, bevor drei entscheidende Fragen beantwortet sind:
- Erreicht das Modell auf den tatsächlichen Aufgaben die nötige Qualität?
- Reichen Ende-zu-Ende-Latenz und Durchsatz für den späteren Betrieb?
- Welche Architektur- und Betriebskosten entstehen über den geplanten Nutzungszeitraum?
Verwaltete Plattformen erlauben es, mehrere Modelle nutzungsabhängig zu testen, ohne zuerst GPUs, Server, Kühlung und Redundanz zu kaufen. Das kann die irreversible Anfangsinvestition reduzieren. Es macht den Pilot nicht automatisch billig: Eingabe- und Ausgabemengen, Modell, Region, Laufzeit, Evaluationsumfang, Speicher, Netzwerk und Zusatzdienste bestimmen die Rechnung.
So bleibt der Test kontrolliert:
- Eine Aufgabe wählen: nicht „KI im Unternehmen“, sondern einen klar definierten Arbeitsschritt mit Prozessverantwortung und Ziel.
- Daten klassifizieren: möglichst mit nachweislich nicht personenbezogenen synthetischen oder tatsächlich anonymisierten Daten beginnen. Pseudonymisierte Daten bleiben personenbezogene Daten. Vor personenbezogenen oder anderweitig schutzbedürftigen Daten gelten die passenden Rechts-, Vertrags- und Sicherheitsgates.
- Recht und Vertrag klären: Zweck und Rechtsgrundlage, Rollen, DPA/AVV, Empfänger, Informationspflichten, Transfers, Löschung und mögliche DSFA.
- Technische Grenzen setzen: erlaubte Modelle und Regionen, Aufbewahrung und Logging, Identitäten und Rollen, private Netzpfade, Verschlüsselung, Secrets und ausgehende Verbindungen.
- Einen identischen Testkorpus verwenden: dieselben repräsentativen Fälle auf allen Kandidaten; öffentliche Benchmarks dienen höchstens der Vorauswahl.
- Vorab Metriken festlegen: Ergebnisqualität, kritische Fehler, Latenz, Durchsatz, Sicherheitsverhalten und vollständige Pilotkosten.
- Budget und Stop-Kriterien definieren: Kostenalarm, interner Prüfzeitraum und Abbruchregeln stehen vor dem ersten Lauf fest.
Das Ergebnis ist kein „bestes Modell der Welt“, sondern das passende Modell für eine konkrete Aufgabe – samt Daten, Messwerten und offenen Risiken.
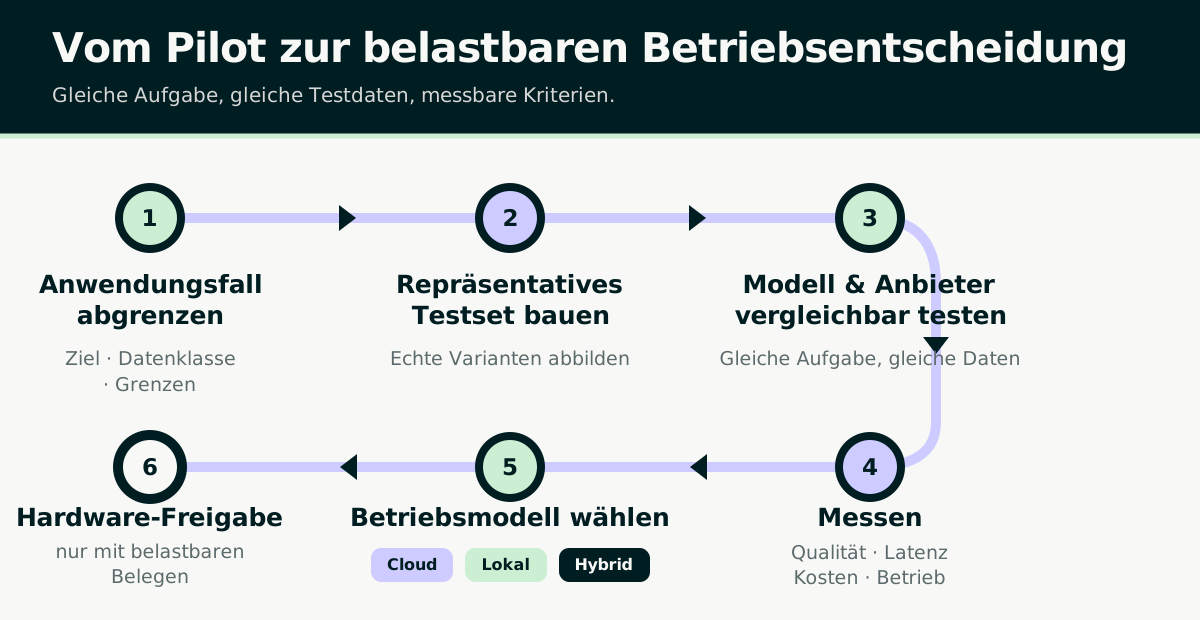
Wogenfels-Entscheidungsablauf für einen kontrollierten Pilot; kein Anbieterbenchmark.
Cloud, lokal oder hybrid: eine Entscheidungsmatrix
| Ausgangslage | Sinnvoller erster Test | Was danach entscheidet |
|---|---|---|
| Modelleignung ist unklar, mehrere Kandidaten kommen infrage | kontrollierter Cloud-Pilot mit gleichem Testkorpus | Qualität, Fehler, Latenz, Durchsatz, Datenpfad und gemessene Kosten |
| Last ist unregelmäßig oder stark schwankend | nutzungsabhängige Cloud- oder Hybridmessung | Spitzenkosten, Leerlauf, Quoten, Skalierung und Betriebsaufwand |
| Last ist stabil, hoch und planbar | Cloud-Benchmark als Vergleich, lokale Option konkret dimensionieren | mehrjährige TCO, Auslastung, Verfügbarkeit und Modellwechsel |
| Daten sind sehr vertraulich oder No-Egress ist gefordert | Pilot mit nicht personenbezogenen Testdaten; lokale oder hybride Architektur vertieft prüfen | gesamte Datenkette, Supportzugriffe, Logs, Telemetrie und Vertragsvorgaben |
| Anwendung muss offline funktionieren | lokaler Proof of Concept | Modell-/Lizenzfit, Updates, Abhängigkeiten, Ausfallsicherheit und Betriebskompetenz |
| Vor Ort gilt eine harte Latenzgrenze | lokale und hybride Ende-zu-Ende-Messung | reale Anwendungslatenz statt isoliertem Modellbenchmark |
| Eigene GPU-/MLOps-Kompetenz fehlt | verwalteten Betrieb zuerst bewerten | Personal, Bereitschaft, Patches, Monitoring und Vertretung |
| Modelle und Anforderungen wechseln häufig | portabler Cloud-Pilot mit dokumentierten Schnittstellen | Lock-in, Lizenz, Migrationsweg und modellspezifische Bedingungen |
Ein hybrider Ansatz kann Daten und Aufgaben bewusst trennen: sensible oder offline notwendige Schritte lokal, wechselnde oder elastische Modellarbeit in einer kontrollierten Cloud. Er ist jedoch nicht automatisch einfacher oder sicherer. Zwei Betriebswelten bedeuten möglicherweise zusätzliche Schnittstellen, doppelte Identitäts-, Monitoring- und Updatepfade, weitere Fehlerzustände sowie die Kosten beider Seiten. Übergaben sollten deshalb im gesamten Datenfluss dokumentiert und samt Zuständigkeiten und Fehlerzuständen bewertet werden.
Wie KMU die TCO eigener Hardware prüfen
Ob sich eigene Hardware wirtschaftlich lohnt, lässt sich nur mit projektspezifischen Vollkosten und Messwerten beurteilen. Dafür müssen die gewählte Modell- und Quantisierungsvariante, Lastprofil, Latenz, Datenklasse, Verfügbarkeit, Lizenz und vorhandene Betriebskompetenz feststehen.
Auf die lokale Seite gehören nicht nur GPUs, sondern auch Server, Speicher, Netzwerk, Strom, Kühlung, Redundanz, Backups, Installation, Monitoring, Sicherheitsupdates, Personal, Bereitschaft, Ersatzteile, Ausfallzeiten und Erneuerung. Auf die Cloud-Seite gehören ebenfalls mehr als Tokenpreise: Datenwege, Speicher, Evaluation, Monitoring, Netzwerk, Support, Reservierungen, Lastspitzen und interne Betriebszeit.
Eine ausfüllbare TCO-Minitabelle hält die kaufmännische Basis für alle Optionen gleich. Alle Werte und der Betrachtungszeitraum sind firmeneigene Eingaben – keine allgemeingültigen Vorgaben:
| Vergleichseingabe | Was einzutragen ist |
|---|---|
| Betrachtungszeitraum | derselbe intern gewählte Zeitraum für Cloud, lokal und hybrid |
| Lastszenarien | Basis-, Spitzen- und Wachstumsszenario mit Geschäftsvorgängen, Eingabe-/Ausgabemenge und Gleichzeitigkeit |
| Einmalige Kosten | Hardware, Einrichtung, Migration, Integration und Schulung |
| Laufende Kosten | Infrastruktur beziehungsweise Nutzung, Speicher, Netzwerk, Lizenz, Support, Personal, Strom und Kühlung |
| Risikokosten | Ausfall, Reserve, Migration, Anbieter-/Modellwechsel und Erneuerung |
| Weitere Annahmen | beispielsweise ein vorsichtig angesetzter möglicher Restwert, getrennt von den Kosten |
| Entscheidungsausgabe | Gesamtkosten je Szenario |
Hardware sollte erst freigegeben werden, wenn nicht nur ein Angebotspreis, sondern diese Nachweise vorliegen:
| Freigabenachweis | Auszufüllende Mussgrenze | Zuständige Rolle | Beleg |
|---|---|---|---|
| Modell, Quantisierung und Speicherbedarf | gewählte Variante plus Qualitätsgrenze | Prozessverantwortung und IT | reproduzierbarer Testbericht |
| Durchsatz und gleichzeitige Nutzer | benötigte Basis-, Spitzen- und Wachstumsleistung | Prozessverantwortung | Ende-zu-Ende-Lasttest |
| Latenz | maximal zulässige Zeit des gesamten Vorgangs | Prozessverantwortung und IT | Anwendungsmessung, nicht nur Modellbenchmark |
| Verfügbarkeit und Reserve | akzeptierte Ausfallzeit, Redundanz und Wiederanlauf | Geschäftsführung und IT | Betriebs-/Notfallkonzept |
| Strom, Kühlung und Standort | geprüfte Kapazität und laufende Kosten | IT und Finanzen | technisches Angebot und TCO |
| Support, Ersatz und Erneuerung | Reaktionsweg, Ersatzteil- und Updatepfad | Einkauf und IT | Vertrags- und Lebenszyklusnachweis |
Die Matrix im vorigen Abschnitt zeigt, wann eine lokale Rechnung besonders prüfenswert wird. Sie beweist noch keine Rentabilität. Entscheidend sind dokumentierte Anforderungen, Risiken und Messwerte.
Freigabe-Checkliste: Fragen, Rollen und Nachweise
Vor personenbezogenen oder anderweitig schutzbedürftigen Daten und vor einer Hardwarebestellung sollte jede Antwort einen Verantwortlichen, einen Nachweis und die Entscheidung freigeben, nachbessern oder stoppen erhalten.
Zweck und Daten
- Welcher konkrete Geschäftszweck und welche messbare Zielgröße gelten?
- Welche Datenklassen gelangen an welche Komponente – einschließlich Logs, Embeddings, Backups und Support?
- Welche Testdaten sind nachweislich nicht personenbezogen oder tatsächlich anonymisiert?
Recht und Vertrag
- Welche Rechtsgrundlage, Informationspflichten und Löschregeln gelten?
- Wer ist Verantwortlicher, Auftragsverarbeiter oder Unterauftragsverarbeiter?
- Welche internationalen Übermittlungen und Remote-Zugriffe bleiben bestehen?
Technik und Sicherheit
- Welche Modellversion, Lizenz, Region, Deployment-Art, API und Zusatzfunktionen werden verwendet?
- Werden Inhalte zum Training genutzt, für Abuse Monitoring geprüft oder durch zustandsbehaftete Funktionen gespeichert?
- Wie sind Identitäten, Berechtigungen, private Netzwege, Schlüssel, Egress, Monitoring und Störungen geregelt?
Test, Kosten und Betrieb
- Welche eigenen Testfälle, Qualitätsgrenzen und kritischen Fehler definieren die fachliche Freigabe?
- Welche Last-, Latenz- und Kostendaten fließen in die TCO ein?
- Wer verantwortet Updates, Löschung, Betrieb und regelmäßige Neubewertung?
Die Rollenverteilung ist eine Governance-Vorlage, keine gesetzlich vorgeschriebene Aufbauorganisation. In kleinen Unternehmen können Rollen gebündelt oder mit externer Unterstützung besetzt werden:
| Rolle | Verantwortet im Gate | Nachweis |
|---|---|---|
| Geschäftsführung | Budget, Ziel, akzeptiertes Restrisiko und Endentscheidung | Entscheidungsnotiz mit Freigabe/Nachbesserung/Stopp |
| Prozessverantwortung | Testfälle, Nutzen, Qualitäts- und Fehlergrenzen | fachlicher Test- und Abnahmebericht |
| IT/Security | Datenfluss, Identitäten, Netz, Betrieb und Notfallweg | Architektur- und Betriebskonzept |
| Datenschutz-/Rechtsrolle, intern oder extern | Rechtsgrundlage, Information, Rollen, DPA/AVV, Transfers und DSFA-Schwelle | dokumentierte Datenschutz-/Vertragsprüfung |
| Einkauf/Finanzen | Anbieterunterlagen, Laufzeit, TCO und Beschaffungsbedingungen | vergleichbare Angebote und TCO-Blatt |
Wenn eine Antwort nur „der Anbieter ist DSGVO-konform“ oder „das läuft lokal“ lautet, fehlt noch die eigentliche Prüfung.
Fazit: erst den Anwendungsfall beweisen, dann die Infrastruktur festlegen
„Nur lokale KI ist DSGVO-konform“ klingt vorsichtig, führt aber zu falscher Sicherheit. Lokale Systeme können Datenwege und Abhängigkeiten reduzieren; sie erben trotzdem die Pflichten der konkreten Verarbeitung und schaffen eigene Betriebsrisiken. Kontrollierte Cloud-Plattformen können Vertrags-, Regions-, Netzwerk- und Aufbewahrungsmechanismen bereitstellen; auch sie werden erst durch passende Auswahl, Konfiguration und Organisation zu einem vertretbaren Teil der Lösung.
Für viele KMU ist daher diese Reihenfolge vernünftig:
- Anwendungsfall und Daten sauber eingrenzen.
- Rechtliche und technische Mindestbedingungen festlegen.
- Mehrere Modelle mit identischen Aufgaben und begrenztem Budget testen.
- Qualität, Risiko, Last und Vollkosten messen.
- Danach Cloud, lokale Hardware oder Hybrid entscheiden.
So kaufen Sie keinen Server für ein Modell, das Ihre Aufgabe nicht gut genug löst – und wählen keine Cloud, deren Datenpfad nicht zu Ihren Anforderungen passt.
Wenn Sie diesen Entscheidungsweg für einen konkreten Prozess aufsetzen möchten, finden Sie hier, wie Wogenfels KI-Anwendungen im Unternehmen analysiert und umsetzt. Der sinnvolle nächste Schritt ist kein Produktkauf, sondern ein abgegrenzter Anwendungsfall mit überprüfbaren Freigabekriterien.
Quellen und Aktualität
Die zentralen Rechtsquellen sind die DSGVO, die Informationen der österreichischen Datenschutzbehörde zu KI und zu Unternehmenspflichten sowie der EDSA-Leitfaden zu Verantwortlichen und Auftragsverarbeitern.
Für die Anbieterbewertung wurden offizielle Vertrags-, Datenschutz-, Regions-, Netzwerk- und Produktdokumente von AWS, Google Cloud und Microsoft verwendet. Die im Text direkt verlinkten Detailseiten sind Teil des Quellenstands vom 15. September 2026. Vor einer konkreten Architektur- oder Freigabeentscheidung müssen die für Modell, Region, API, Funktionen und Vertrag geltenden Fassungen erneut geprüft werden.
- KI
- DSGVO
- Cloud
- Lokale KI
- KI-Infrastruktur
Weitere Beiträge
Bestellmails mit KI verarbeiten: Architektur-Fallstudie
Ein geprüfter Entwicklungsstand zeigt, wie Bestellmails und PDFs zu kontrollierten ERP-Vorschlägen werden, mit Menschenprüfung und Xentral-Anbindung.
Mein Web-Stack für KMU: statisch starten, dynamisch ergänzen
Warum Wogenfels KMU-Websites mit Astro statisch beginnt, Dynamik per Hono abgrenzt, Persistenz nur vorbereitet und Qualität automatisiert prüft.
Hermes Agent oder n8n? So bauen KMU einen kontrollierten KI-Mitarbeiter
Hermes Agent oder n8n? Der Vergleich zeigt KMU, wann ein Agent, ein fester Workflow oder eine kontrollierte Kombination sinnvoll ist.